Dlaczego ChatGPT zmyśla źródła i jak sprawdzić każde w 30 sekund
W skrócie: Dlaczego ChatGPT zmyśla źródła? Bo przewiduje kolejne słowa zamiast przeszukiwać katalog biblioteczny, a nazwisko, rok i numer DOI to dla niego takie same słowa jak każde inne. Niżej znajdziesz cztery rodzaje wpadki, które trafiają do bibliografii, sygnały, po których promotor rozpoznaje zmyślone źródło bez sprawdzania czegokolwiek, weryfikację jednego przypisu w 30 sekund oraz procedurę na sytuację, w której nieistniejąca pozycja siedzi już w oddanym rozdziale.
Wpisujesz w Google Scholar tytuł książki, który podał Ci ChatGPT, razem z nazwiskiem autora i rokiem. Zero wyników. Sprawdzasz numer DOI, ten, który wyglądał najbardziej wiarygodnie z całego przypisu. Prowadzi do artykułu o czymś zupełnie innym.
Wtedy przychodzi pytanie, które słyszę od Was najczęściej: czy zrobiłam coś źle w zapytaniu. Nie zrobiłaś. Model zachował się dokładnie tak, jak działa, i za chwilę pokażę, dlaczego to nie awaria.
Czym są halucynacje modelu i dlaczego zmyślone źródło wygląda lepiej niż prawdziwe
Model językowy nie sprawdza, czy książka istnieje. Przewiduje, jakie słowo najprawdopodobniej pada po poprzednim, a przypis bibliograficzny ma budowę tak regularną, że przewiduje się go wyjątkowo łatwo.
Nazwisko, inicjał, tytuł kursywą, wydawnictwo, miasto, rok, numer strony, czyli dokładnie ten układ, który opisuję w tekście o tym, jak robić przypisy w pracy licencjackiej i magisterskiej. Elementy stoją w polskich pracach zawsze w tej samej kolejności, więc model odtwarza wzór bez trudu i wypełnia go najbardziej prawdopodobną treścią. Stąd bierze się coś, co brzmi jak paradoks: zmyślony przypis często wygląda schludniej niż prawdziwy, bo nie ma w nim żadnej nieregularności, jaką ma realna bibliografia.
W panelu o nauczaniu analityków wywiadu wyłożono to przez statystykę: halucynacja wynika z tego, jak model liczy prawdopodobieństwo kolejnych elementów, a nie z błędu w danych. Podano tam trafność odpowiedzi na poziomie 60 do 70 procent, przy czym dotyczy to zadań analitycznych w tamtym programie nauczania, nie polskich prac dyplomowych (Davis i in. 2025, 08:46 i 09:14).
Zjawisko ma swoją nazwę: halucynacja modelu językowego. W polskich tekstach częściej przeczytasz, że „ChatGPT kłamie”, i to sformułowanie myli tropy. Kłamstwo wymaga intencji oraz wiedzy o tym, jak jest naprawdę, a model statystyczny nie ma ani jednego, ani drugiego. Zmyśla tym samym mechanizmem, którym podaje prawdziwą informację, i sam tych dwóch sytuacji nie odróżnia.
Dotyczy to wszystkich dużych modeli językowych, nie jednego produktu. Claude, Gemini i modele GPT od OpenAI halucynują na tej samej zasadzie, bo wszystkie wytrenowano na tekstach i wszystkie generują odpowiedź, przewidując następne słowo na podstawie prawdopodobieństwa. Wybierając inne narzędzie, zmieniasz częstotliwość wpadek, a nie ich rodzaj.
Druga rzecz wynika z konstrukcji rozmowy. Model zawsze udziela odpowiedzi, bo do tego został zbudowany, i nie ma wbudowanego stanu „nie wiem, gdzie to sprawdzić” (Renfro, Hawthorne i Hawkins 2025, 29:13). Jeśli poprosisz o pięć pozycji o wąskim polskim zagadnieniu, dostaniesz pięć pozycji, także wtedy, gdy w rzeczywistości istnieją dwie.
Warto zapamiętać jedno rozróżnienie, bo zdejmuje złudzenia co do nowszych modeli. Nowszy model halucynuje rzadziej, nie przestaje halucynować. Dokładność zależy przy tym mocniej od tematu niż od nazwy narzędzia: przy faktach uznanych i szeroko opisanych jest wysoka, przy zagadnieniach spornych i niuansowych bywa loterią (Gast 2025, 44:19). Polska praca dyplomowa z wąskiego tematu siedzi dokładnie w tej drugiej kategorii.
Ile znaczy „rzadziej”, widać w badaniach, w których ktoś sprawdził przypis po przypisie. William Walters i Esther Wilder przejrzeli 636 pozycji bibliograficznych z 84 krótkich prac napisanych przez ChatGPT. GPT-3.5 zmyślił 55% z nich, GPT-4 18%, a wśród źródeł prawdziwych błędy merytoryczne w opisie miało odpowiednio 43% i 24% (Walters i Wilder 2023, art. 14045). Zespół Joy Buchanan sprawdził to samo na ekonomii: ponad 30% cytowań od GPT-3.5 nie istniało, GPT-4 wypadł tylko trochę lepiej, a im bardziej szczegółowe pytanie, tym mniej trafne odpowiedzi (Buchanan, Hill i Shapoval 2024, s. 80). Najnowszy pomiar dotyczy GPT-4o i przeglądów literatury o zdrowiu psychicznym. Na 176 cytowań 35 (19,9%) okazało się zmyślonych, a w 64 ze 141 prawdziwych (45,4%) był błąd (Linardon i in. 2025, art. e80371). Razem to 99 przypisów na 176, czyli ponad połowa do poprawki albo do kosza. Wszystkie trzy zespoły pytały po angielsku o tematy dobrze opisane w literaturze, więc przy wąskim polskim temacie trudno liczyć na lepszy wynik.
Zmyślone przypisy zdarzają się też tam, gdzie na sprawdzanie są pieniądze i zespoły prawników. W maju 2025 roku prawnicy firmy Anthropic przepraszali sąd federalny w Kalifornii, bo w opinii biegłej, złożonej w sporze z wydawcami muzycznymi, znalazł się przypis wygenerowany przez Claude. Artykuł istniał, link i rok publikacji się zgadzały, ale tytuł i autorzy były błędne (TechCrunch 2025; Adamczyk 2026, slajd 12). Kilka miesięcy później Deloitte zgodził się oddać australijskiemu Departamentowi Zatrudnienia i Stosunków Pracy ostatnią ratę wynagrodzenia za raport wart 440 tys. dolarów australijskich. Naukowcy znaleźli w nim nieistniejące publikacje i zmyślony cytat z wyroku sądu federalnego (Johnson 2025). W obu sprawach za błąd odpowiadali ludzie, którzy podpisali dokument, a pod pracą dyplomową stoi Twoje nazwisko.
Cztery rodzaje wpadki, które trafiają do bibliografii
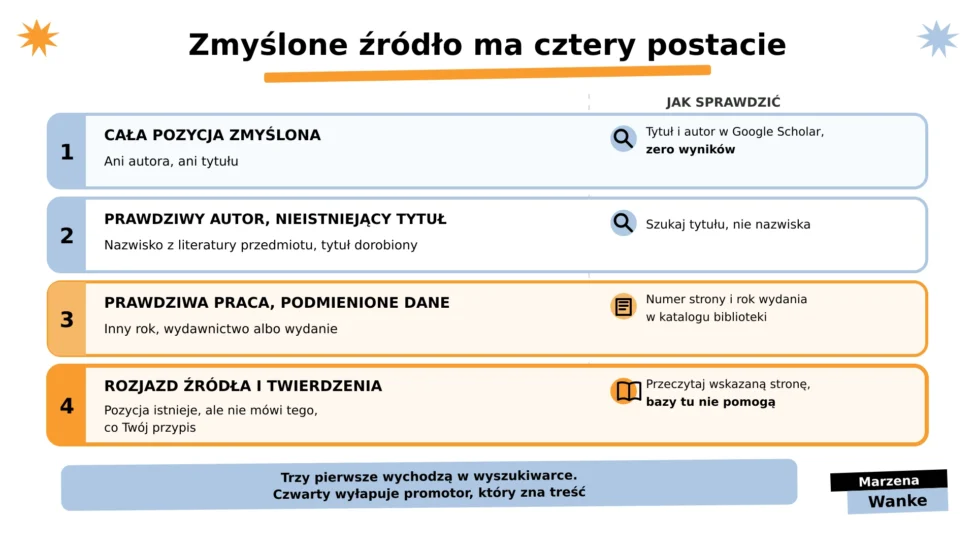
Zmyślone źródło ma cztery postacie i różnią się one trudnością wykrycia. Najgroźniejsza jest ta czwarta, bo pozycja w niej istnieje i da się ją znaleźć, tylko nie mówi tego, co przypisuje jej Twój przypis.
Najprostszy przypadek to źródło zmyślone w całości. Nie ma autora, nie ma tytułu, nie ma wydawnictwa. Google Scholar zwraca zero wyników, Worldcat zero, katalog Biblioteki Narodowej zero. W tekstach, które czytam u Was, ten rodzaj spotykam częściej niż podmianki, i to jest dobra wiadomość, bo wychodzi w pierwszej sekundzie sprawdzania.
Gorzej wygląda sytuacja, w której autor jest prawdziwy, a tytuł nie istnieje. Model zna nazwisko z literatury przedmiotu, dokłada do niego tytuł zbudowany z najczęstszych słów Twojej dziedziny i wychodzi pozycja, której ten badacz nigdy nie napisał. Tu pułapka jest gorsza, bo pierwsze wyszukiwanie po nazwisku daje wyniki i łatwo uznać sprawę za zamkniętą.
Ten rodzaj nazwali po imieniu lekarze z Erasme Hospital i Uniwersytetu w Mediolanie, w liście do redakcji czasopisma „Critical Care”. Opisali go jako osobny, podstępny typ halucynacji, który napotkali w swojej własnej pracy:
Pozornie poprawne odniesienia bibliograficzne ze znanymi autorami i spójnymi tytułami, które jednak w całości nie istnieją.
M. Salvagno, F.S. Taccone, A.G. Gerli, Artificial intelligence hallucinations, „Critical Care” 2023, t. 27, art. 180, DOI 10.1186/s13054-023-04473-y, s. 1 (tłumaczenie własne).
Bywa też tak, że publikacja istnieje, ale jej dane wydawnicze się nie zgadzają: rok, wydawnictwo albo wydanie. Numer strony jest w tej grupie najsłabszym punktem modeli i wykładowcy wskazują go jako pierwsze miejsce do sprawdzenia (Forbes 2025, 26:11). Przypis z paginacją, której nie ma w tym wydaniu, jest łatwy do wykazania.
Najtrudniejsza do wyłapania jest czwarta postać, czyli rozjazd między źródłem a twierdzeniem. Pozycja istnieje, autor istnieje, rok się zgadza, a zdanie w Twojej pracy mówi coś, czego w tej książce nie ma. W panelu o dowodach użycia AI nazwano to rozjechaniem cytowań i opisano jako częstszy problem niż całkowita fabrykacja (Renfro, Hawthorne i Hawkins 2025, 30:28). Ten rodzaj przechodzi weryfikację przez Google Scholar, bo źródło się znajduje. Wyłapuje go dopiero ktoś, kto zna treść, czyli Twój promotor.
Ważne!
Fabrykowanie odniesień bibliograficznych przez duże modele językowe przyjmuje cztery postacie o różnym stopniu wykrywalności: całkowitą fabrykację pozycji, przypisanie istniejącemu autorowi nieistniejącego tytułu, modyfikację danych wydawniczych publikacji rzeczywistej oraz rozjazd między treścią źródła a twierdzeniem, które jest mu przypisywane. Trzy pierwsze postacie weryfikuje się przez zapytanie w bazie bibliograficznej. Czwarta wymaga dotarcia do treści źródła, dlatego pozostaje niewykrywalna dla procedur opartych wyłącznie na sprawdzeniu istnienia publikacji.
Przypis: Opracowanie własne na podstawie: M. Salvagno, F.S. Taccone, A.G. Gerli, Artificial intelligence hallucinations, „Critical Care” 2023, t. 27, art. 180, DOI 10.1186/s13054-023-04473-y, s. 1; Z. Renfro, H. Hawthorne, J. Hawkins, Generative AI, Academic Integrity and the Question of Evidence, panel online, APUS, 2025, [29:13], [30:28], [40:00]; J. Forbes, Faculty Perspectives of Educational Integrity and AI: In Their Own Words, wykład online, APUS, 2025, [24:37], [26:11].
Po czym promotor poznaje zmyślone źródło, jeszcze nic nie sprawdzając
Dla wykładowców fałszywe źródła są sygnałem numer jeden przy podejrzeniu AI, a sprawdzają przypisy wyrywkowo. Wystarczy więc jedna nieistniejąca pozycja, żeby rozmowa przestała dotyczyć Twojej pracy i zaczęła dotyczyć Twojej rzetelności.
W badaniu wśród wykładowców fałszywe albo błędne odniesienia wypadły jako najczęściej wskazywany sygnał użycia AI. W tym samym wystąpieniu pada druga rzecz, o której warto wiedzieć: sprawdzenie wszystkich przypisów jest nierealne, bo przy setkach odnośników tygodniowo nikt tego nie robi. Weryfikacja idzie próbką (Forbes 2025, 24:37 i 26:11).
Z Twojej perspektywy zmienia to rachunek prawdopodobieństwa w niewygodną stronę. Promotor nie sprawdzi trzydziestu pozycji, sprawdzi trzy. Wybierze te, które go zainteresowały albo których nie zna, a to zwykle są dokładnie te, które model dorobił, bo nie istnieją w obiegu.
Zanim pomyślisz, że to problem studentów pierwszego roku: ci sami autorzy z „Critical Care” opisują w tym liście własną wpadkę. Rycina w ich opublikowanym artykule, napisanym z ChatGPT, okazała się zasadniczo błędna i czasopismo wydało sprostowanie. Autorzy formułują z tego jeden wniosek: model nie spełnia kryteriów autorstwa, a odpowiedzialność za ścisłość podanych informacji zostaje zawsze po stronie człowieka, który się podpisał (Salvagno, Taccone i Gerli 2023, s. 1). Dodają też, że treść wygenerowaną przez model powinien zweryfikować ktoś znający dziedzinę, nawet jeśli chodzi o samo tłumaczenie.
Jest też powód, dla którego ta sprawa jest gorsza niż podobieństwo w raporcie antyplagiatowym. Procent z systemu zawsze da się omówić, bo zależy od próby porównawczej i od tego, co wyłączono ze sprawdzenia. Nieistniejąca książka nie daje pola do dyskusji. W panelu o dowodach użycia AI błędne dane bibliograficzne nazwano sprawą rozstrzygniętą z góry (Renfro, Hawthorne i Hawkins 2025, 40:00).
Dochodzi rzecz, która zaskakuje najbardziej: promotor często nie musi niczego wpisywać w wyszukiwarkę. Osoba, która od lat prowadzi seminaria w jednym obszarze, zna literaturę swojego tematu i widzi obcą pozycję w wykazie tak, jak Ty widzisz obce nazwisko na liście obecności swojej grupy.
Weryfikacja jednego przypisu w 30 sekund
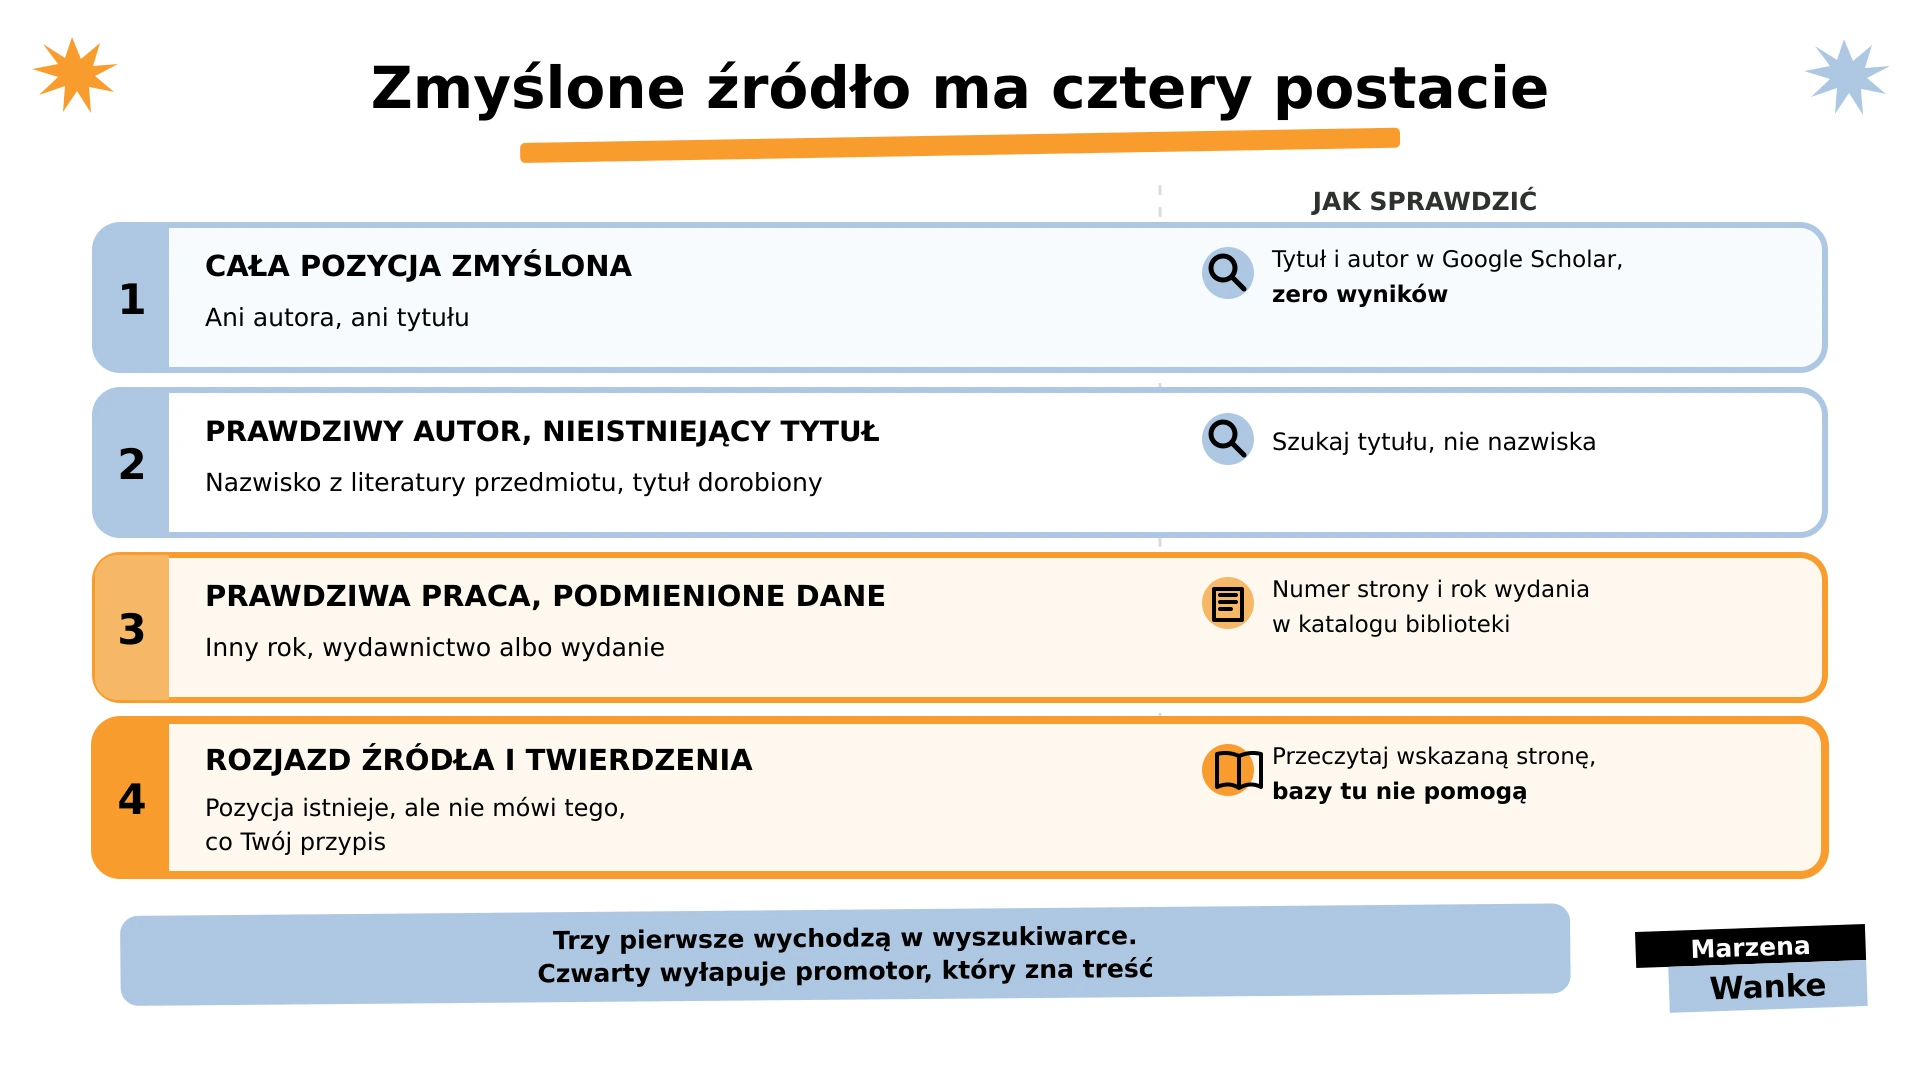
Trzy kroki, w tej kolejności: tytuł do bazy, potem rok i strona, na końcu treść wskazanej strony. Pierwsze dwa kroki zajmują pół minuty, trzeci robisz tylko przy pozycjach, na których opierasz twierdzenie.
Zanim zaczniesz, jedna uwaga o kolejności: weryfikacja informacji idzie tu od najtańszego sprawdzenia do najdroższego. Krok pierwszy dotyczy tytułu, nie nazwiska. Skopiuj sam tytuł do Google Scholar i sprawdź, czy istnieje. Szukanie po nazwisku jest tu pułapką, bo autor zwykle jest prawdziwy i wyniki się pojawią, przez co odhaczysz pozycję, która nie istnieje. Brak wyniku na tytuł oznacza, że dalej nie ma czego szukać.
Potem przychodzą dane wydawnicze i paginacja. Znajdź pozycję w katalogu biblioteki i porównaj rok, wydawnictwo oraz wydanie. Sprawdź, czy strona z przypisu w ogóle mieści się w tym wydaniu. To najszybsze miejsce na wykrycie podmianki, bo numery stron są najsłabszym punktem modeli (Forbes 2025, 26:11).
Ostatnie sprawdzenie jest najwolniejsze, dlatego robisz je wybiórczo. Otwórz wskazaną stronę i przeczytaj ją. Robisz to przy każdym źródle, na którym stoi Twoja teza, bo tylko tak wyłapiesz czwarty rodzaj wpadki. Na szkoleniu o warsztacie badacza pokazano na tym dwustopniową weryfikację: najpierw istnienie publikacji, potem zgodność treści z twierdzeniem (Janik 2026, cz. 4).
| Co sprawdzasz | Gdzie | Co oznacza wynik negatywny |
|---|---|---|
| tytuł publikacji | Google Scholar, katalog Biblioteki Narodowej, Worldcat | pozycja nie istnieje, wyrzuć ją z pracy |
| rok, wydawnictwo, wydanie | katalog biblioteki uczelnianej | dane podmienione, popraw opis albo znajdź właściwe wydanie |
| numer strony | egzemplarz albo podgląd wydania | strona poza zakresem, przypis do poprawy |
| treść wskazanej strony | sam tekst źródła | rozjazd źródła i twierdzenia, najtrudniejszy do wykrycia |
| numer DOI | doi.org | prowadzi do innej pracy albo nie działa, pozycja niepewna |
Mój Tip: Nie zostawiaj weryfikacji na koniec pisania. Sprawdzaj każdą pozycję w tej samej minucie, w której trafia do Twojego pliku z notatkami, i dopisuj przy niej link albo sygnaturę z katalogu. Brzmi jak zbędna biurokracja dokładnie do momentu, w którym masz sto pozycji, oddajesz pracę w piątek i nie pamiętasz, które z nich pochodzą od modelu, a które z biblioteki.
Nie wiesz, jak wygląda zmyślone źródło, dopóki nie zobaczysz go obok prawdziwego. W minikursie „3 błędy” pokazuję na prawdziwych zrzutach ekranu halucynowany cytat, źródło, którego nie ma, i ślad formatowania AI. Trzy maile, konkretne przykłady z Waszych prac.
Zmyślone źródło siedzi już w oddanym rozdziale. Co teraz
Zgłoś to sama, zanim promotor zapyta. Wymiana jednej pozycji na prawdziwą to poprawka redakcyjna, a ta sama pozycja znaleziona przez promotora zamienia się w rozmowę o samodzielności pracy.
Kolejność ma tu znaczenie i wynika z prostego rachunku. Jeśli przychodzisz z informacją „sprawdziłam bibliografię i dwie pozycje trzeba wymienić”, jesteś osobą, która kontroluje swój warsztat. Jeśli promotor znajduje to pierwszy, przestaje pytać o rozdział i zaczyna pytać, co jeszcze w tej pracy powstało w ten sposób.
Sama poprawka ma trzy etapy i tylko pierwszy jest oczywisty. Wyrzucasz nieistniejącą pozycję z wykazu. Potem, i o tym wiele osób zapomina, sprawdzasz twierdzenie, które na niej stało, bo skoro źródło pochodziło od modelu, to zdanie też. Na końcu szukasz prawdziwego źródła dla tego twierdzenia albo usuwasz zdanie, jeśli takiego źródła nie ma.
Dobrą ramą na tę sytuację jest procedura, którą na jednym z webinarów podano jako cztery kroki brania odpowiedzialności za tekst z AI: sprawdź źródło pierwotne, skonfrontuj je z niezależnymi, skoryguj błędy i luki, a na końcu sygnuj tylko to, za co bierzesz odpowiedzialność (Adamczyk 2026, slajd 28). Ostatni krok jest tym, który rozstrzyga o Twojej pracy, bo podpisujesz się pod całością, także pod przypisami wklejonymi w pośpiechu.
Tam, gdzie kończy się symulacja, tam zaczyna się odpowiedzialny wniosek.
H. Adamczyk, AI w warsztacie badacza i dydaktyka. Inspiracje, dobre praktyki i zagrożenia, wystąpienie, 22 maja 2026, slajd 17.
Ta sama osoba formułuje regułę, którą warto powtarzać przy każdym gładko brzmiącym akapicie: płynność nie jest prawdą. Tekst spójny, ładny i przekonujący nie jest przez to prawdziwy, kompletny ani oparty na źródłach (Adamczyk 2026, slajd 27). Zmyślony przypis brzmi lepiej niż prawdziwy właśnie dlatego, że powstał z samej płynności.
Jak pracować, żeby to się nie powtarzało
Zmień tryb, nie narzędzie. W trybie domyślnym model odpowiada z pamięci i sięga po Wikipedię, w trybie głębokiego badania przeszukuje strony i podaje klikalne linki, a przy pracy na wgranych plikach cytuje to, co mu dałaś.
Zacznij od trybu. Kiedy zmuszasz model do trybu głębokiego badania, odpowiada etapami, przeszukuje realne strony i podaje odnośniki, które da się otworzyć. Domyślna odpowiedź na to samo pytanie często opiera się na Wikipedii, która nie jest źródłem naukowym. Ta jedna zmiana zdejmuje z Ciebie największą część roboty weryfikacyjnej.
Osobną sprawą jest dobór narzędzia do zadania. Perplexity w pierwszej kolejności szuka w źródłach naukowych i podaje cytowania, dlatego sama używam go do zbierania literatury, a cały sposób pracy opisałam w tekście o tym, jak zebrać źródła do pracy licencjackiej w 30 minut. Przekonanie, że Perplexity nie halucynuje, jest jednak mitem: linkuje źródła, ale zdarzają mu się odnośniki, które nie mówią tego, co przypisuje im odpowiedź (Lopez 2025, 46:01). Weryfikacja zostaje po Twojej stronie.
Najbezpieczniej pracuje się na własnych plikach. Narzędzie, które odpowiada wyłącznie z wgranych przez Ciebie dokumentów, cytuje konkretne fragmenty i nie ma skąd wziąć nieistniejącej pozycji (McMichael, 22:49). Jeśli masz już PDF-y swoich źródeł, to najbezpieczniejszy sposób pracy z rozdziałem teoretycznym.
Zostają jeszcze cztery prompty kontrolne, które warto wkleić do własnej ściągawki. Wpisujesz je po każdej odpowiedzi, którą zamierzasz wykorzystać. „Wskaż słabe strony i błędy tej odpowiedzi.” „Pokaż luki w rozumowaniu i to, czego w tym momencie nie widzę.” „Znajdź autorów, którzy uważają inaczej niż ten.” „Pokaż główny nurt badawczy i nurty poboczne dla tego zagadnienia.” Model potrafi wskazać własne słabe punkty, gdy prompt wprost tego wymaga. Budowę dobrego promptu i techniki, które sama przetestowałam w ChatGPT i Gemini, opisałam we wpisie o tym, jak pisać prompty do pracy licencjackiej.
Autorzy z „Critical Care” opisali tę drogę jako krzywą Dunninga i Krugera przeniesioną na pisanie naukowe z AI, i rozkłada się ona na trzy etapy. Na początku jest nadmierna pewność i przekonanie, że teksty powstaną szybko i niemal same. Potem przychodzi zderzenie z błędnymi odniesieniami i halucynacjami, stracony czas, a często porzucenie narzędzia. Na końcu, wraz ze zrozumieniem ograniczeń i umiejętnością stawiania konkretnych poleceń, AI staje się narzędziem roboczym jak komputer albo wyszukiwarka (Salvagno, Taccone i Gerli 2023, ryc. 1).
Warto wiedzieć, na którym etapie tej krzywej jesteś. Jeśli właśnie znalazłaś pierwsze zmyślone źródło, siedzisz w dołku, w najmniej przyjemnym punkcie całej drogi, i to jest zupełnie normalne. Z tego dołka wychodzi się przez zmianę sposobu pracy.
Mój Tip: Zrób sobie jednorazowy test, który więcej zapamiętasz niż dziesięć ostrzeżeń. Poproś model o pięć źródeł o możliwie wąskim wycinku Twojego tematu, takim na trzy zdania, a potem sprawdź wszystkie pięć w Google Scholar. Zobaczysz, w którym momencie kończy się jego wiedza, a zaczyna uzupełnianie wzoru. Ten moment rozpoznasz później po samym wyglądzie przypisu. To ćwiczenie w wersji dla prowadzących opisano na jednym z warsztatów o AI w dydaktyce (Sandhu i in. 2025, slajdy 17-18).
FAQ: najczęstsze pytania o zmyślone źródła od AI
Dlaczego ChatGPT zmyśla źródła?
Bo przewiduje najbardziej prawdopodobne kolejne słowa, a nie sprawdza katalogu bibliotecznego. Przypis ma bardzo regularną budowę, więc model odtwarza wzór i wypełnia go prawdopodobną treścią, razem z rokiem i numerem DOI. Model zawsze udziela odpowiedzi, także wtedy, gdy nie ma z czego jej zbudować (Renfro, Hawthorne i Hawkins 2025, 29:13).
Czy ChatGPT kłamie, czy halucynuje?
Halucynuje, a słowo „kłamie” jest tu nieprecyzyjne, bo kłamstwo wymaga intencji i wiedzy o stanie faktycznym. Model językowy przewiduje najbardziej prawdopodobne słowo i tym samym mechanizmem podaje informację prawdziwą oraz zmyśloną, nie odróżniając ich od siebie. Dotyczy to wszystkich dużych modeli: ChatGPT, Claude i Gemini.
Jak sprawdzić, czy źródło istnieje?
Skopiuj sam tytuł do Google Scholar, katalogu Biblioteki Narodowej albo Worldcat. Brak wyniku na tytuł oznacza, że pozycja nie istnieje. Szukanie po nazwisku jest pułapką, bo autor zwykle jest prawdziwy i wyniki się pojawią, mimo że tej konkretnej książki nie ma.
Czy nowszy model przestaje zmyślać?
Zmyśla rzadziej, nie przestaje. Dokładność zależy mocniej od tematu niż od nazwy narzędzia: przy faktach szeroko opisanych jest wysoka, przy zagadnieniach wąskich i spornych spada (Gast 2025, 44:19). Polska praca dyplomowa z wąskiego tematu należy do tej drugiej grupy. W badaniu Waltersa i Wilder GPT-4 zmyślił 18% źródeł wobec 55% w GPT-3.5, a GPT-4o w badaniu Linardona i in. z 2025 roku wciąż 19,9%.
Czy Perplexity albo deep research rozwiązują problem?
Zmniejszają ryzyko, bo przeszukują strony i podają klikalne odnośniki, ale go nie usuwają. Perplexity linkuje źródła i zdarzają mu się odnośniki, które nie potwierdzają tego, co napisał w odpowiedzi (Lopez 2025, 46:01). Sprawdzasz i tak, po prostu rzadziej trafiasz na wpadkę.
Czy promotor pozna, że źródło pochodzi od AI?
Fałszywe albo błędne odniesienia wypadają w badaniach wśród wykładowców jako najczęściej wskazywany sygnał użycia AI (Forbes 2025, 24:37). Osoba prowadząca seminarium w jednym obszarze zna literaturę tematu, więc obcą pozycję widzi w wykazie bez sprawdzania. Przypisy weryfikuje się przy tym próbką, nie w całości (Forbes 2025, 26:11). O tym, co w tej sprawie widzi system, a co człowiek, pisałam osobno przy pytaniu, czy JSA wykrywa ChatGPT.
Co zrobić, jeśli zmyślone źródło jest już w oddanym rozdziale?
Zgłoś to promotorowi sama i potraktuj jako poprawkę w trzech krokach: wyrzuć pozycję z wykazu, sprawdź twierdzenie, które na niej stało, i znajdź dla niego prawdziwe źródło albo usuń zdanie. Pozycja znaleziona przez promotora zamienia rozmowę o rozdziale w rozmowę o samodzielności pracy.
Czy zmyślone źródło w bibliografii to plagiat?
To osobne naruszenie, nazywane fabrykacją źródeł, i bywa łatwiejsze do wykazania niż plagiat, bo sprowadza się do sprawdzenia, czy publikacja istnieje. Część polskich uczelni wpisała zakaz fabrykowania źródeł wprost do swoich regulaminów użycia AI, więc sprawdź dokument obowiązujący u Ciebie.
Jeśli masz dziś zrobić jedną rzecz po przeczytaniu tego tekstu, otwórz swoją bibliografię i sprawdź trzy pozycje, których nazw nie kojarzysz z biblioteki ani z seminarium. Wybierz te, przy których pamiętasz, że powstały szybko. Promotor wybierze dokładnie te same.
Zmyślony cytat wygląda inaczej, gdy wiesz, czego szukać. W minikursie „3 błędy” rozbieram trzy wpadki, które promotor widzi od razu: halucynowany cytat, źródło, którego nie ma, i ślad formatowania AI. Wszystkie na zrzutach ekranu z prawdziwych rozmów z modelem.
Źródła wykorzystane w tym wpisie
- Adamczyk H., AI w warsztacie badacza i dydaktyka. Inspiracje, dobre praktyki i zagrożenia, wystąpienie, 22 maja 2026, slajdy 12, 17, 20-21, 27-28.
- Anthropic’s lawyer was forced to apologize after Claude hallucinated a legal citation, „TechCrunch”, 15.05.2025, techcrunch.com [dostęp: 6.10.2026].
- Buchanan J., Hill S., Shapoval O., ChatGPT Hallucinates Non-existent Citations: Evidence from Economics, „The American Economist” 2024, t. 69, nr 1, s. 80-87, DOI 10.1177/05694345231218454.
- Davis V., Hess, Kochevar, Burch, AI in the Classroom: Intelligence Studies, panel online, American Public University System, 2025, [08:46], [09:14].
- Forbes J., Faculty Perspectives of Educational Integrity and AI: In Their Own Words, wykład online, American Public University System, 2025, [24:37], [26:11].
- Gast N., panel From Idea to Impact, American Public University System, 2025, [44:19].
- Janik M., Warsztat badacza w dobie LLM: Przełom w analizie danych czy zagrożenie dla rzetelności naukowej?, szkolenie online, projekt B-KINETIC, Spinus, 14.09.2026, część 4.
- Johnson C., Deloitte to part repay government over dodgy AI report, for which it got $440,000, „Region Canberra”, 8.10.2025, region.com.au [dostęp: 6.10.2026].
- Linardon J., Jarman H., McClure Z., Anderson C., Liu C., Messer M., Influence of Topic Familiarity and Prompt Specificity on Citation Fabrication in Mental Health Research Using Large Language Models: Experimental Study, „JMIR Mental Health” 2025, t. 12, art. e80371, DOI 10.2196/80371.
- Lopez D., AI and the Future of Education: Innovations in Learning and Teaching for Student Success, keynote online, American Public University System, 2025, [45:29], [46:01].
- McMichael K., From Task Completion to Deep Learning: Helping Students Use AI as a Learning Partner, wykład online, American Public University System, [22:49].
- Renfro Z., Hawthorne H., Hawkins J., Generative AI, Academic Integrity and the Question of Evidence, panel online, konferencja „AI and the Future of Education”, American Public University System, 16-17 października 2025, nagranie ok. 61 min, wypowiedzi [29:13], [30:28] i [40:00].
- Salvagno M., Taccone F.S., Gerli A.G., Artificial intelligence hallucinations, „Critical Care” 2023, t. 27, art. 180, DOI 10.1186/s13054-023-04473-y (list do redakcji, dostęp otwarty) [dostęp: 29.09.2026].
- Sandhu A., Bastian, Dima-Ala, Workshop: Navigating AI in the Classroom, warsztat, American Public University System, 2025, slajdy 17-18.
- Walters W.H., Wilder E.I., Fabrication and errors in the bibliographic citations generated by ChatGPT, „Scientific Reports” 2023, t. 13, art. 14045, DOI 10.1038/s41598-023-41032-5.
Przy wystąpieniach konferencyjnych i webinarach kotwicą jest znacznik czasu albo numer slajdu, bo materiały te nie mają paginacji.