Prompty do pracy licencjackiej, które uczą Cię pisać, zamiast pisać za Ciebie
W skrócie: Prompty do pracy licencjackiej i magisterskiej dzielą się na dwa rodzaje. Jedne zwracają tekst do wklejenia: rozdział, definicję, wstęp. Drugie zwracają pytanie, na które musisz odpowiedzieć sam. Tekst z ChatGPT zostawia ślad w JSA i wychodzi na obronie, kiedy komisja pyta, dlaczego przyjąłeś taką definicję. Co konkretnie zostaje w raporcie, pokazuję w tekście o tym, jak działa JSA. Pytanie nie daje ani zdania do skopiowania, więc nie ma czego wykrywać, a Ty wiesz, co masz w pracy. Poniżej pięć promptów drugiego rodzaju, z instrukcją, na którym etapie pisania pracy ich użyć i jak sprawdzić, czy AI nie zmyśla. Nie ma promptu, który napisze pracę za Ciebie. Jest za to budowa promptu i kilka technik, które sprawdziłam w ChatGPT i Gemini: z nimi odpowiedź nadaje się do dalszej pracy.
Dlaczego większość promptów do pracy licencjackiej działa przeciwko Tobie?
Bo powstały po to, żeby skrócić pisanie, a nie żeby zrozumieć temat. Wpisz w Google „prompty do pracy licencjackiej”. Pierwszy wynik daje 10 szablonów, inny 18 promptów i triki w e-booku do pobrania, kolejny zbiera prompty, które mają pomóc napisać pracę magisterską od tematu pracy po zakończenie, a w grupie ChatGPT Polska na Facebooku najczęstsze pytanie brzmi: „jaki jest skuteczny prompt, żeby GPT napisał całą pracę na podstawie spisu treści i hipotez”. Wszystkie te prompty mają jedną wspólną cechę. Ty wpisujesz, AI pisze, Ty wklejasz.
Kelly McMichael, historyczka z American Public University, opisała ten mechanizm na konferencji o AI w edukacji. Uczelnie od lat nagradzają ukończenie zadania, nie ciekawość. Student nauczył się więc odhaczać, a ChatGPT tylko przyspieszył to, co działo się wcześniej z gotowcami z internetu. Efektem jest pokolenie, które wie, jak zdobyć odpowiedź, ale nie umie zbudować własnego wniosku.
W polskich realiach ten mechanizm kończy się na obronie. Komisja pyta, dlaczego oparłeś rozdział drugi na definicji Armstronga, a nie Pocztowskiego. Nie wiesz, bo nie Ty ją wybrałeś. Wrycza-Bekier pisze wprost: praca dyplomowa ma udowadniać nie tylko, że przeczytałeś to, co miałeś przeczytać, ale przede wszystkim, że potrafisz samodzielnie myśleć (Wrycza-Bekier 2011, s. 112). Prompt, który pisze za Ciebie, odbiera Ci jedyny dowód, jaki masz do pokazania.
Czym różni się prompt, który pisze, od promptu, który uczy?
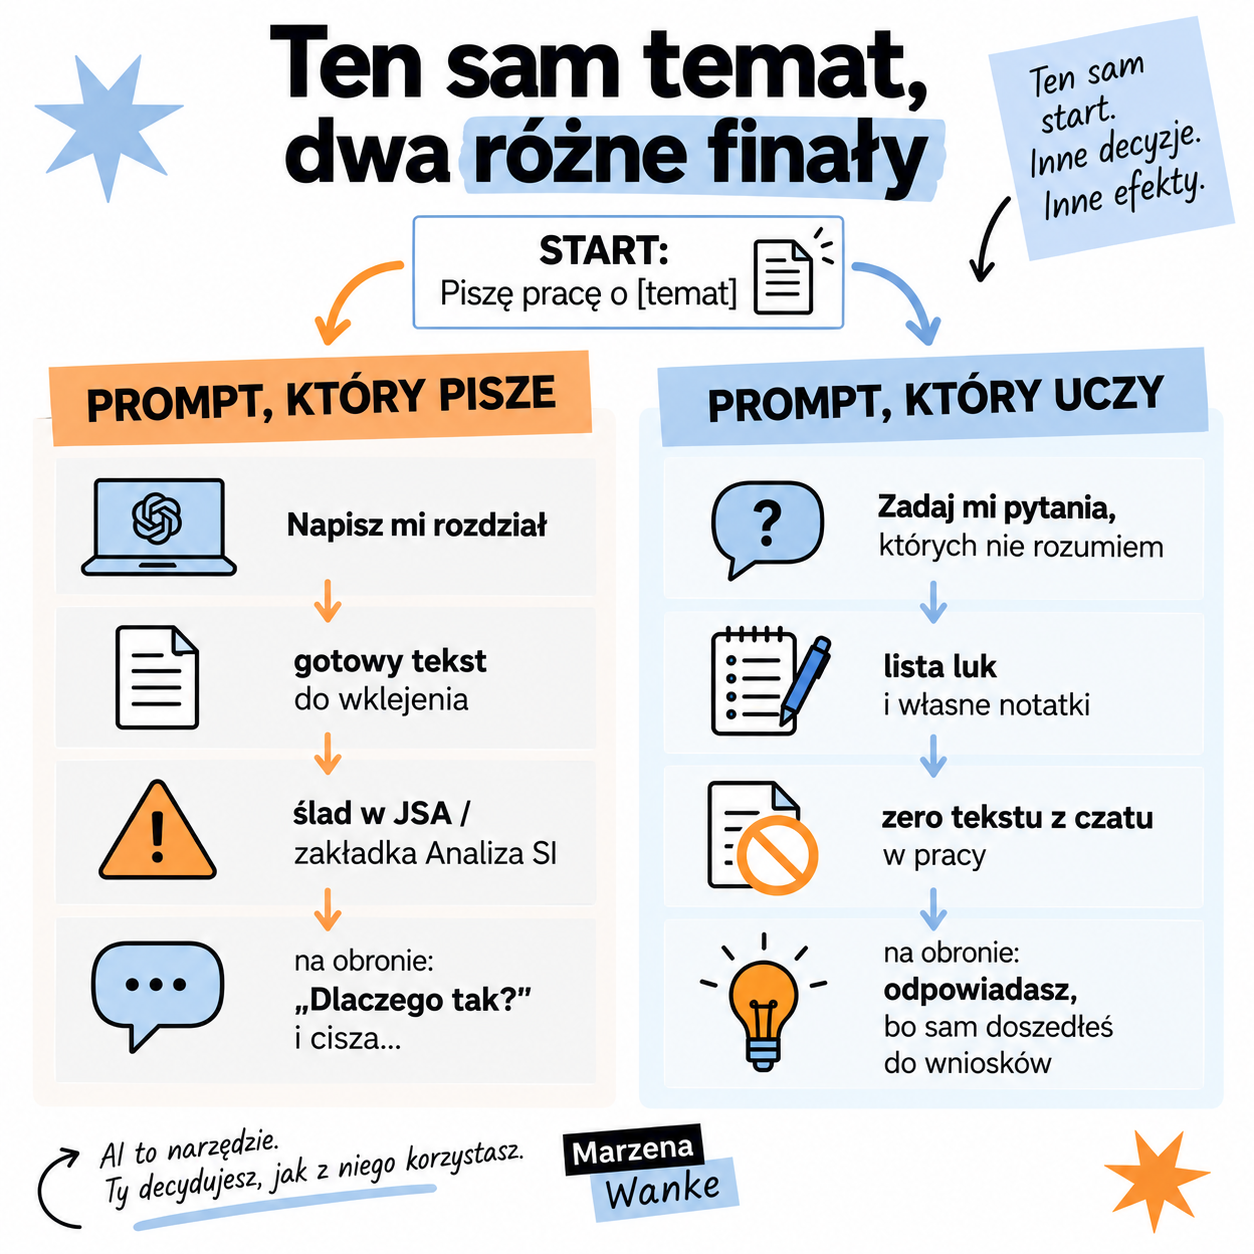
Prompt, który pisze, zwraca tekst. Prompt, który uczy, zwraca pytanie, lukę albo kontrargument, z którym musisz coś zrobić. McMichael używa trzech obrazów: sztuczna inteligencja może być lustrem, które odbija Twoje myślenie i je pogłębia, mikroskopem, który pozwala zobaczyć szczegół, albo placem zabaw do testowania pomysłów. W żadnej z tych ról nie pisze za Ciebie. Ja mówię o tym samym od pierwszego filmu o metodzie 3K: to Ty jesteś autorem i nadzorcą całego procesu, a AI jest asystentem i wykonawcą Twoich poleceń, nie źródłem wiedzy. Prompt, który uczy, trzyma ten podział ról. Prompt, który pisze, go odwraca.
Różnica w praktyce wygląda tak:
| Prompt, który pisze | Prompt, który uczy | |
|---|---|---|
| Co wpisujesz | „Napisz podrozdział o motywacji płacowej” | „Zadaj mi pięć pytań o motywację płacową, na które nie umiem odpowiedzieć” |
| Co dostajesz | 600 słów do wklejenia | Pięć pytań i listę tego, czego nie wiesz |
| Co zostaje w głowie | Nic, bo nie Ty to pisałeś | Mapa luk, które zamykasz lekturą |
| Ślad w JSA | Fragment o niskiej perplexity, oznaczony w zakładce Analiza SI | Brak, bo w pracy nie ma ani zdania z czatu |
| Na obronie | „Dlaczego tak?” i cisza | Odpowiadasz, bo sam doszedłeś do wniosku |
Zanim otworzysz ChatGPT, McMichael proponuje trzy pytania. Cel: co próbuję lepiej zrozumieć, a nie co chcę mieć napisane. Proces: co ma zrobić AI, a co ja, i w którym momencie przejmuję. Personalizacja: jak dopasować rozmowę do tego, jak się uczę, a nie do tego, co oddam promotorowi. Jeśli na pierwsze pytanie odpowiadasz „chcę mieć rozdział”, składasz zlecenie. Nauka zaczyna się od innej odpowiedzi. Trzy pytania w jednym miejscu, do zapisania na kartce przy monitorze:
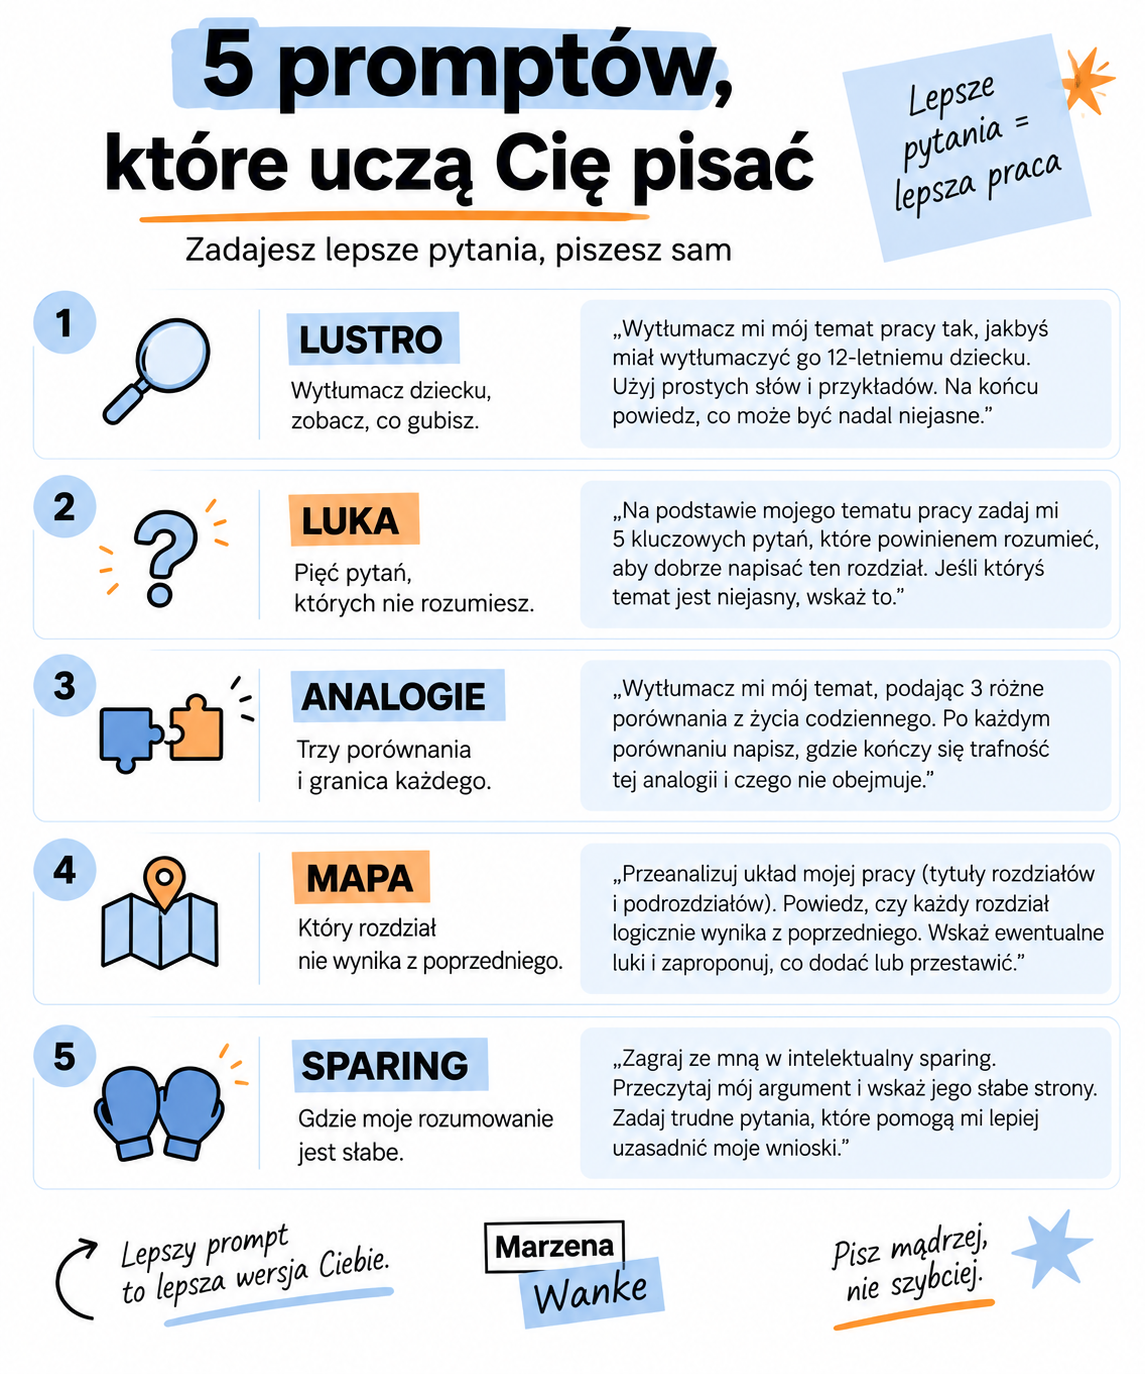
Pięć promptów do pracy licencjackiej, które pogłębiają Twoje myślenie
Każdy z tych promptów kończy się tym, że to Ty piszesz, a nie AI. Cztery pierwsze pochodzą z wykładu McMichael i zostały przełożone na etapy pracy dyplomowej. Piąty to jej odpowiedź na pytanie z sali o to, jak wykorzystać sztuczną inteligencję do oceny własnych pomysłów, a nie do ich generowania. Trzy z nich znasz w innej wersji z mojego filmu o tym, jak pisać z AI lepiej niż 95% studentów: tryb wywiadu, mapa projektu badawczego i samokrytyka modelu. Działają w ChatGPT, Claude i Gemini, bo nie opierają się na żadnej funkcji konkretnego narzędzia AI. Studenci w komentarzach nazywają to krócej: „ChatGPT, ale z głową”.
1. Lustro: wytłumacz dziecku, potem pokaż, co zgubiłem
Wytłumacz [pojęcie z mojego rozdziału teoretycznego] tak, jakbym tłumaczył je ciekawskiemu dziesięciolatkowi. Potem wypisz, co w tym uproszczeniu gubi się z naukowego punktu widzenia i które rozróżnienia muszę zachować w pracy.
Kiedy: przy definicjach w rozdziale teoretycznym, gdy masz trzy definicje z trzech podręczników i nie widzisz, czym się różnią. Co zrobić z odpowiedzią: przepisać własnymi słowami listę rozróżnień i sprawdzić w źródłach, czy AI ich nie wymyśliło. Uwaga: model chętnie upraszcza tak, że gubi to, na czym zależy promotorowi. Druga część promptu jest po to, żeby ten koszt zobaczyć. Odwrotna wersja tego samego ćwiczenia: „jesteś moim uczniem, wytłumaczę Ci to pojęcie, dopytuj o wszystko, czego nie rozumiesz”. Jeśli nie umiesz wytłumaczyć, jeszcze nie rozumiesz.
2. Luka: pięć pytań, na które nie umiem odpowiedzieć
Piszę pracę licencjacką na temat [temat]. Zadaj mi pięć pytań, które ujawnią, czego jeszcze nie rozumiem. Po każdej mojej odpowiedzi oceń ją w dwóch zdaniach i zadaj kolejne, trudniejsze pytanie.
Kiedy: przy konspekcie i wstępie, gdy próbujesz sformułować temat pracy i problem badawczy, zanim zaczniesz pisać. Co zrobić z odpowiedzią: pytania, na które odpowiadasz „nie wiem”, to lista lektur na najbliższy tydzień. McMichael mówi o tym prompcie, że prowadzi studenta do tego, czego nie wie, że nie wie. Wrycza-Bekier nazwałaby to czytaniem sokratejskim: Sokrates zamiast podawać wiedzę, zadawał pytania (Wrycza-Bekier 2011, s. 16). Tu pyta model, a Ty musisz mieć odpowiedź. W filmie nazwałam to trybem wywiadu: zamiast tłumaczyć AI, co chcesz zrobić, piszesz „wiem, że wielu rzeczy jeszcze nie wiem, pomóż mi ustalić, czego brakuje w moim rozumowaniu” i pozwalasz, żeby to model zadawał pytania.
3. Analogie: trzy porównania i granica każdego
Podaj trzy analogie do [pojęcie] z trzech różnych dziedzin. Przy każdej wskaż, w którym miejscu analogia przestaje działać.
Kiedy: we wstępie, gdy szukasz sposobu na wyjaśnienie pojęcia, i przed obroną, gdy chcesz mówić bez czytania z kartki. Co zrobić z odpowiedzią: wybrać jedną analogię, sprawdzić jej granicę i użyć na obronie własnymi słowami. Uwaga: analogia przydaje się w wypowiedzi ustnej. W rozdziale teoretycznym zostają definicje z przypisem.
4. Mapa: pokaż, który rozdział nie wynika z poprzedniego
Oto mój konspekt: [wklejasz]. Zamień go w opis zależności między rozdziałami: co z czego wynika. Oceń spójność całości. Wskaż miejsce, w którym kolejny rozdział nie wynika z poprzedniego, i zadaj mi pytanie, które pomoże mi to naprawić.
Kiedy: po pierwszej wersji konspektu, przed pokazaniem go promotorowi. Co zrobić z odpowiedzią: przerysować konspekt na kartce jako ciąg strzałek. Jeśli strzałki się urywają, tam jest dziura w logice. Najwięcej daje to przy części metodologicznej, która sprawia studentom najwięcej trudności: mapa pokazuje z lotu ptaka, co właściwie chcesz zbadać i czy hipotezy wynikają z pytań badawczych. Amerykańska studentka z wykładu McMichael użyła podobnego promptu, żeby wygenerować diagram procesu, którego nie umiała sobie wyobrazić. AI dało jej materiał, a obraz zbudowała sama.
5. Sparing: gdzie moje rozumowanie jest słabe
O [zagadnienie] piszą [autor A] w [tytuł] i [autor B] w [tytuł]. Ich stanowiska streszczam tak: [dwa zdania]. Moje stanowisko brzmi: [trzy zdania]. Wskaż, gdzie moje rozumowanie jest najsłabsze, jaki kontrargument postawiłby recenzent i jakiego źródła mi brakuje, żeby się obronić.
Kiedy: przy argumentacji w rozdziale badawczym, zwłaszcza przy interpretacji wyników ankiety, gdzie łatwo pomylić korelację z przyczyną, i w tygodniu przed obroną. Co zrobić z odpowiedzią: kontrargument zapisać i odpowiedzieć na niego w pracy, zanim zada go komisja. Uwaga: streszczenia autorów piszesz sam. Jeśli poprosisz o nie model, sparing odbędzie się między AI a AI, a Ty tylko patrzysz. Ten prompt działa też w drugą stronę: po każdej dłuższej odpowiedzi modelu poproś go o wskazanie słabych stron tego, co właśnie napisał. Model zawsze tę krytykę znajdzie, a Ty widzisz rzeczy, które byś przeoczył. Dołóż prośbę o autorów, którzy uważają inaczej niż ten, na którym opierasz rozdział. Byłeń dodaje do tego zasadę, która przydaje się i tutaj: nie należy bezkrytycznie poddawać się sugestii autorytetów (Byłeń 2017, s. 207). Dotyczy to też modelu, który brzmi pewnie.
Prompt zapasowy na blokadę. McMichael opowiedziała o studencie fizyki, który napisał do ChatGPT: „jestem znudzony i bez motywacji, zrób z tego coś zabawnego”. Model odpowiedział „dobra, zjedźmy prawa Newtona, aż nabiorą sensu”. Student się roześmiał, czytał dalej i przyznał później: „ten głupi roast zmusił mnie do nauki”. To przykład z amerykańskiej uczelni, ale mechanizm jest uniwersalny: emocja podtrzymuje wytrwałość. Jeśli od trzech dni nie otworzyłeś pliku z pracą, poproś model, żeby streścił Twój rozdział w stylu komentatora sportowego. Do pracy nic z tego nie trafi, ale plik zostanie otwarty.
Mój Tip: po każdej rozmowie z tego zestawu zamknij czat i zapisz trzy zdania własnymi słowami: czego się dowiedziałem, czego nie wiem, co czytam jutro. Te notatki są dowodem procesu pisania, gdyby promotor spytał, jak pracowałeś z AI.
Na którym etapie pracy użyć którego promptu?
Każdy z pięciu promptów ma swój etap i każdy kończy się Twoją własną notatką, nie tekstem z czatu. Zestawienie dla pracy licencjackiej i magisterskiej wygląda tak samo, różni się tylko liczba rozdziałów:
| Etap pracy | Prompt | Co dostajesz | Co robisz dalej |
|---|---|---|---|
| Temat i konspekt | 2. Luka, 4. Mapa | Listę pytań bez odpowiedzi, dziury w logice rozdziałów | Lista lektur, poprawiony konspekt na kartce |
| Rozdział teoretyczny | 1. Lustro | Rozróżnienia między definicjami | Sprawdzasz je w źródłach, piszesz sam |
| Rozdział metodologiczny | 2. Luka, 5. Sparing | Pytania o to, czy hipoteza wynika z literatury i czy problem badawczy da się zmierzyć | Uzasadniasz hipotezę źródłami, bo hipoteza musi znaleźć uzasadnienie w literaturze specjalistycznej (Byłeń 2017, s. 206) |
| Rozdział badawczy i analiza wyników | 5. Sparing | Kontrargument do Twojej interpretacji danych i brakujące źródło | Odpowiadasz na kontrargument w tekście |
| Obrona | 3. Analogie, 5. Sparing | Sposób mówienia o pojęciu, pytania komisji | Ćwiczysz odpowiedzi na głos |
| Blokada | Prompt zapasowy | Otwarty plik | Wracasz do etapu, na którym utknąłeś |
Jeśli szukasz promptów, które pomagają zaplanować strukturę rozdziału i szukać literatury, opisałam je w tekście o rozdziale teoretycznym z ChatGPT. Tamte prompty porządkują materiał, te z dzisiejszego wpisu sprawdzają, czy go rozumiesz. Używa się ich razem, w tej kolejności.
Wiesz już, jak sprawdzić, czy ChatGPT nie zmyśla. W minikursie pokazuję trzy błędy, które promotor widzi od razu, na prawdziwych zrzutach ekranu z prawdziwych prac. Trzy maile, zero teorii.
Jak pisać prompty do pracy licencjackiej: budowa promptu i techniki, które przetestowałam
Gotowy prompt działa tylko w takim zakresie, w jakim pasuje do Twojej pracy. Dobry prompt zbudujesz sam, jeśli wiesz, z czego się składa i jakie techniki zmieniają odpowiedź. Zamiast kolejnej listy szablonów sprawdziłam więc, co naprawdę zmienia jakość odpowiedzi. Wzięłam elementy i techniki, które w pracy z AI sprawdzają się od dawna, i przetestowałam je na pisaniu pracy dyplomowej.
Warunki testu były proste. Jedna wymyślona praca licencjacka z zarządzania zasobami ludzkimi: wdrażanie nowych pracowników w małej firmie handlowej. ChatGPT w czacie tymczasowym, bez historii rozmów, a przy jednym teście także Gemini. Każdy wariant w nowym oknie, żeby model nie korzystał z poprzednich odpowiedzi. Testy zrobiłam 6 października 2026 roku, więc za pół roku wyniki mogą wyglądać inaczej. Same zasady raczej się nie zmienią.
Z czego składa się dobry prompt
Podstawą dobrego promptu są cztery części: rola, zadanie, kontekst i format odpowiedzi. Natalia Gietka dokłada dwie kolejne: ograniczenia, czyli czego nie chcesz, oraz zdanie na końcu, które każe modelowi sprawdzić, jak zrozumiał zadanie. Zwraca też uwagę na kolejność. Model nadaje największą wagę temu, co stoi na początku, dlatego rola i najważniejszy kontekst idą na górę, a prośba o pytania na sam koniec (Gietka 2026, slajd „Jak promptować?”). Do tego dochodzą przykłady, które często działają mocniej niż samo polecenie.
Razem wychodzi siedem bloków. Nie każdy prompt potrzebuje wszystkich, ale każdy, któremu czegoś brakuje, odpowiada ogólniej.
1. Rola: kim ma być model (promotorka, recenzent, metodolog).
2. Zadanie: co dokładnie ma zrobić i co ma być efektem.
3. Kontekst: kierunek, poziom pracy, temat, metoda, czas na badanie, wymagania promotora.
4. Przykłady: wzór, który Ci odpowiada, z jednym zdaniem, dlaczego jest dobry.
5. Format: tabela, lista, liczba pozycji, długość.
6. Ograniczenia: czego model ma nie robić, na przykład nie pisać gotowych akapitów.
7. Meta‑polecenie: „napisz, jak rozumiesz zadanie, zadaj mi pytania i nie zaczynaj, dopóki nie odpowiem”.
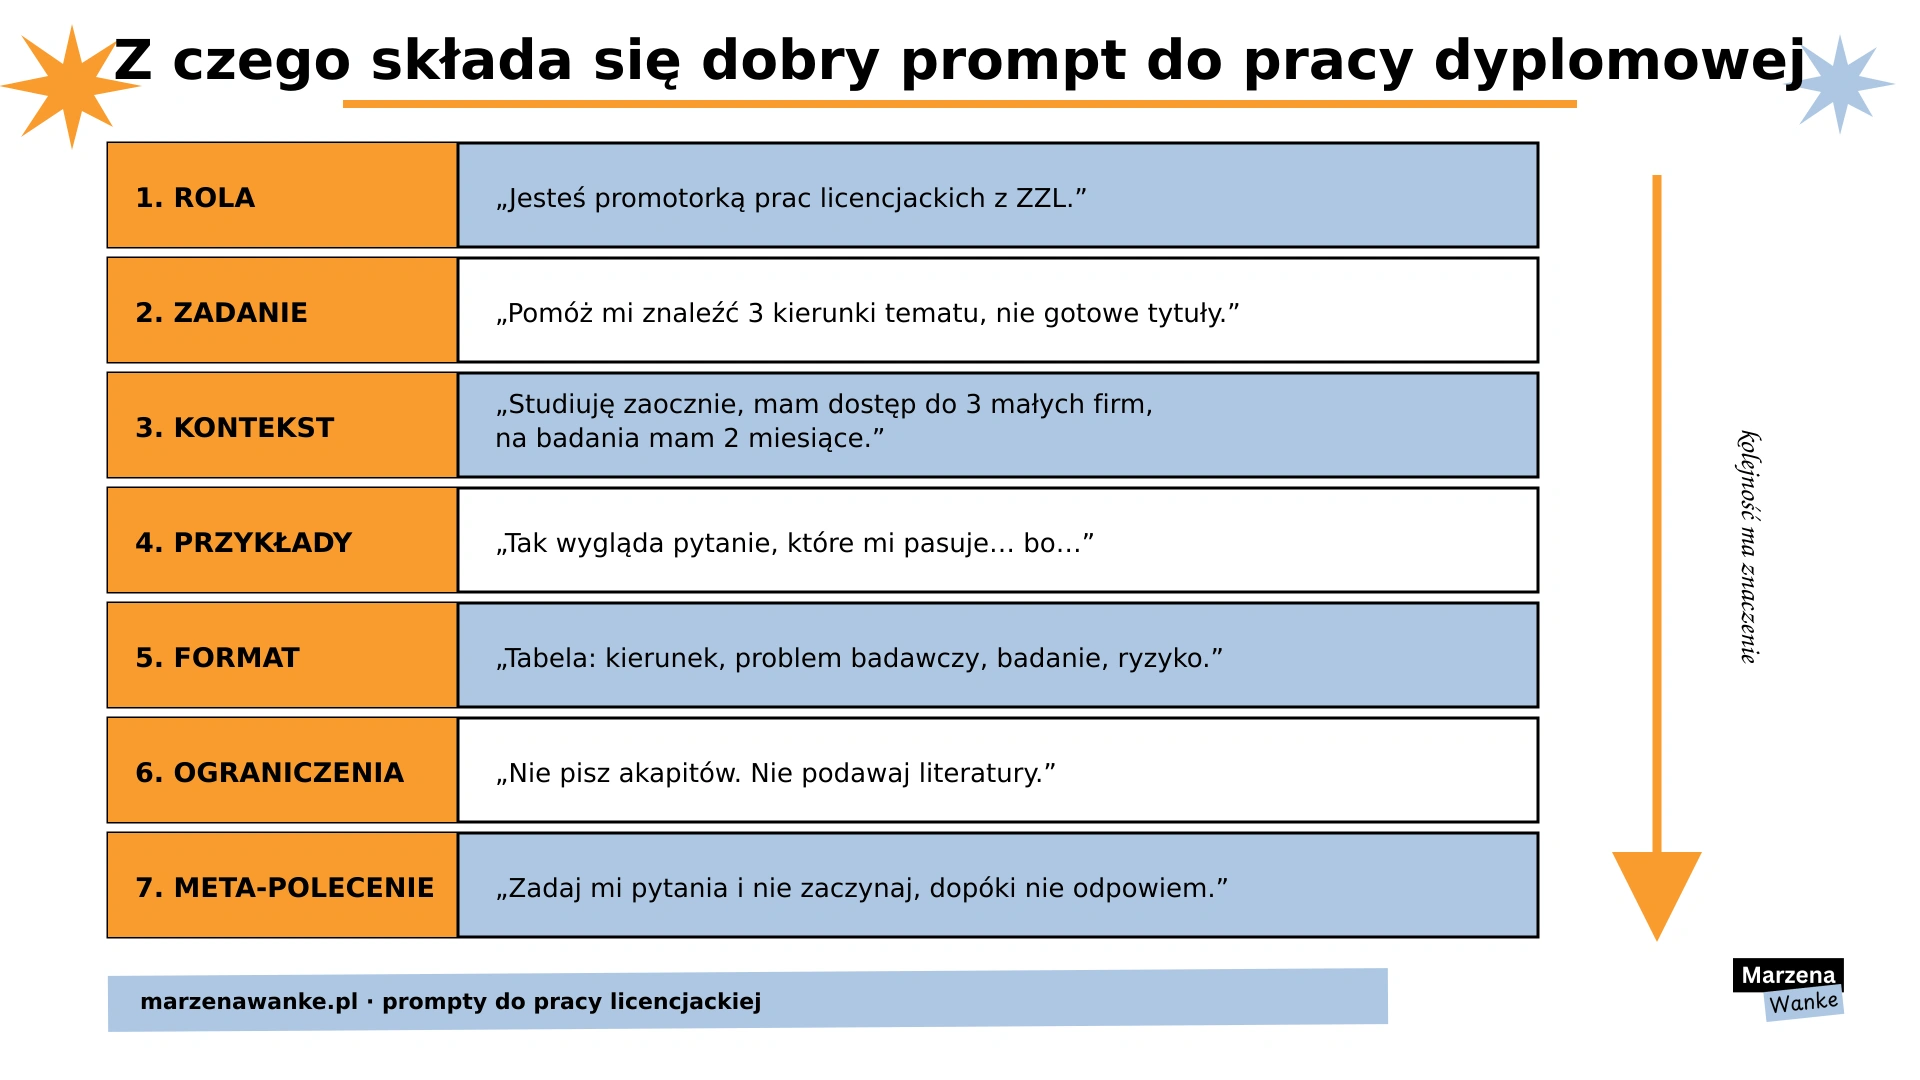
Na tę budowę nakładają się techniki, czyli sposoby prowadzenia rozmowy z modelem: przykłady z komentarzem, łańcuch decyzji, pytanie o sam prompt i meta‑polecenie z zatrzymaniem. Każdy element i każdą technikę sprawdziłam na jednej pracy.
1. Element: rola. To samo pytanie, trzy różne odpowiedzi
Zadałam trzy razy to samo pytanie o zmienną pośredniczącą. Za pierwszym razem bez żadnej roli, za drugim w roli promotorki, za trzecim w roli recenzenta, który ocenia zdanie studenta „zmienną pośredniczącą jest staż pracy”.
Bez roli dostałam poprawną definicję z przykładem o godzinach nauki i wyniku egzaminu. Nic z tego nie przeniesiesz do pracy z ZZL. Promotorka wytłumaczyła to samo na dwóch nowych pracownikach: jedna osoba dostała plan wdrożenia i opiekuna, druga komputer i kilka dokumentów. Dorzuciła gotowy zapis hipotez i ostrzeżenie, że mediator wymaga uzasadnienia teoretycznego, a sama korelacja trzech zmiennych go nie dowodzi. Recenzent zaczął od oceny, że zdanie studenta jest „niewystarczające, a najprawdopodobniej błędne”, i podał pytanie, które zadałby na obronie: czym różni się zmienna pośrednicząca od kontrolnej.
Tak samo działa to między ludźmi: to samo pojęcie inaczej wytłumaczy wykładowca na pierwszym roku, a inaczej recenzent na obronie. Promotorka tłumaczy, recenzent szuka słabego punktu, a model bez roli odpowiada jak podręcznik.
Reguła: wybierz rolę, której odpowiedzi potrzebujesz. Do zrozumienia pojęcia sięgnij po promotorkę, a do sprawdzenia własnego tekstu po recenzenta.
2. Elementy: zadanie, kontekst, format. Brief zamiast jednego zdania
Pierwszy prompt brzmiał: „Daj mi temat pracy licencjackiej z zarządzania zasobami ludzkimi”. W odpowiedzi przyszło 15 tytułów do skopiowania, rada, żeby wybrać „temat łatwy do napisania”, i propozycja: przygotuję Ci 10 tematów razem z problemem badawczym, pytaniami, hipotezami i spisem treści. Bez żadnych ram model sam ciągnie w stronę pisania za Ciebie.
Drugi prompt miał cztery części, które tworzą szkielet dobrego polecenia: rolę, zadanie, kontekst i format odpowiedzi.
Rola: jesteś promotorką prac licencjackich z zarządzania zasobami ludzkimi na polskiej uczelni.
Zadanie: pomóż mi znaleźć 3 kierunki tematu pracy licencjackiej. To punkt wyjścia do zawężania, nie gotowe tytuły.
Kontekst: studiuję ZZL zaocznie, pracuję w małej firmie handlowej (15 osób), mam dostęp do pracowników tej firmy i dwóch podobnych. Interesuje mnie wdrażanie nowych pracowników. Nie chcę pisać o wynagrodzeniach. Na badania mam 2 miesiące.
Format: tabela z kolumnami: kierunek, czego dotyczy, przykładowy problem badawczy, jakie badanie da się zrobić w moich warunkach, ryzyko.
Ten sam model odpowiedział jak promotorka, która zna Twoją sytuację: „Przy Twoich warunkach nie szłabym w szeroki temat onboardingu”. Zaproponował kierunki do zbadania w trzech małych firmach i doradził, żeby w ankiecie ograniczyć się do osób zatrudnionych w ostatnich 2-3 latach, bo starsi pracownicy nie pamiętają już swoich początków. Ostrzegł też przed pisaniem o „wpływie” przy jednorazowej ankiecie.
Jedna rzecz nie zadziałała. Dopisałam „nie podawaj konkretnych pozycji literatury”, a model i tak wstawił odnośniki do źródeł, bo w tym czacie miał włączone wyszukiwanie w sieci. Zakaz w prompcie nie wyłącza narzędzi.
Mój Tip: zanim napiszesz kontekst do promptu, wypisz cel i pytania badawcze na karteczce i przyklej ją przy monitorze, nawet w wersji roboczej. Pracę pisze się pod cel. Kontekst, który z niego wynika, wpiszesz potem do każdego promptu w minutę.
Reguła: rola, zadanie, kontekst, format. Najwięcej daje kontekst, czyli to, czego model o Tobie nie wie: kierunek, warunki badania, czas, czego nie chcesz. Tę samą zasadę omawiam w filmie o Metodzie 3K: klarowność, kontekst, kontrola.
3. Technika: przykład z komentarzem i antyprzykład
Przykład często mówi modelowi więcej niż najdłuższe polecenie. Najlepiej działa przykład z komentarzem, dlaczego jest dobry, i przykład tego, czego nie chcesz, też z komentarzem.
Sprawdziłam to na pytaniach badawczych. Bez przykładów model zaczął od pytania „Jak przebiega proces wdrażania nowych pracowników w małej firmie handlowej?”. To pytanie zbyt szerokie, dokładnie z rodzaju tych, które promotor odrzuca. W drugim wariancie dałam dwa dobre pytania i dwa złe, każde z jednym zdaniem komentarza, na przykład: „Czy onboarding jest ważny?”, komentarz: odpowiedź jest oczywista, niczego nie mierzy. Model najpierw sam wypisał reguły dobrego pytania i rozpisał je dokładniej, niż ja to zrobiłam.
Potem przyszedł haczyk. Jedno z trzech pytań było prawie kopią mojego przykładu, a dwa pozostałe pytały o to samo innymi słowami: o elementy wdrożenia „najbardziej pomocne” i o formy wsparcia „najbardziej przydatne” w pierwszych trzech miesiącach. Model nauczył się stylu tak dobrze, że przestał szukać nowych tropów.
Reguła: dawaj przykłady z komentarzem i dopisz: „nie powtarzaj moich przykładów, każde pytanie ma dotyczyć innego aspektu”.
4. Technika: łańcuch decyzji z kryteriami zamiast pytania „co o tym sądzisz?”
Spodziewałam się, że model pochwali każdy cel pracy, więc dałam mu słaby: „Celem pracy jest pokazanie, że onboarding jest ważny dla firmy”. Nie pochwalił. Od razu napisał, że cel jest zbyt ogólny i zakłada z góry wniosek.
Problem wyszedł gdzie indziej. Jako najlepszą poprawkę polecił cel o tym, „w jakim stopniu proces onboardingu wpływa na adaptację”, i to przy ankiecie. Jednorazowa ankieta nie pokaże wpływu przyczynowego, więc taki cel recenzent łatwo podważy. W drugim wariancie poprosiłam o trzy wersje celu, ocenę każdej według moich kryteriów (czy da się to zbadać w 2 miesiące, czy wiadomo, co będzie badane, czy cel nie zakłada wyniku) i wybór najlepszej. Tym razem model sam zauważył, że słowo „wpływa” jest problemem i że łatwiej badać związek albo postrzegany wpływ.
Tak działa łańcuch decyzji: najpierw opcje, potem ocena mocnych i słabych stron, na końcu wybór z uzasadnieniem. W moim teście była jeszcze druga lekcja. Wszystkie trzy własne propozycje model ocenił na „bardzo dobrą”, z kompletem pozytywnych ocen, choć wybrany przez niego cel mówił o „ocenie znaczenia” onboardingu i nie było jasne, co właściwie miałoby być badane. Swoje odpowiedzi AI ocenia łagodnie.
Reguła: kryteria dajesz Ty. Dopisz: „przy każdej propozycji, także swojej, wskaż co najmniej jedną słabość”.
5. Technika: inżynieria wsteczna, czyli zapytaj model o własny prompt
Kiedy dostaniesz dobrą odpowiedź, zapytaj, jak napisać prompt, żeby następnym razem dostać ją od razu. To inżynieria wsteczna. Zaraz potem zadaj drugie pytanie: „Czego Ci zabrakło w tym prompcie?”.
Po teście z celem pracy poprosiłam o szablon. Dostałam porządny prompt z miejscami do uzupełnienia, z jedną wadą: na końcu kazał podać „rekomendowaną wersję celu w gotowej formie, którą mogę wykorzystać w pracy”. Wtedy zapytałam, czego brakuje w tym szablonie. Druga runda wyłapała to, czego nie wyłapała pierwsza. Model dopisał problem badawczy, charakter badania (opisowe, porównawcze, korelacyjne), sposób analizy danych i wymagania promotora. Sam też poprawił własne kryterium „co będę mierzyć”, bo zakładało badanie ilościowe i nie pasowało do pracy jakościowej.
Reguła: po dobrej odpowiedzi poproś o szablon promptu, a potem zapytaj, czego w nim brakuje. Zanim go użyjesz, usuń z niego wszystko, co każe modelowi napisać fragment pracy za Ciebie.
6. Technika: meta‑polecenie. Prośba o pytania nie wystarczy, każ modelowi czekać
Natalia Gietka poleca kończyć prompt zdaniem, które każe modelowi napisać, jak zrozumiał zadanie, i dopytać o braki. W jej teście na tę prośbę dopytał tylko ChatGPT, a Gemini i Copilot od razu generowały odpowiedź (Gietka 2026, cz. B, 13:06-13:24).
U mnie wyszło odwrotnie. Do promptu o streszczenie artykułu naukowego dopisałam: „Zanim zaczniesz, napisz, jak zrozumiałeś to zadanie, i zadaj mi pytania, jeśli czegoś potrzebujesz”. ChatGPT dokładnie opisał zadanie i odpisał: „Nie potrzebuję od Ciebie dodatkowych informacji”. Gemini zadał jedno pytanie i w tej samej odpowiedzi, nie czekając na moją, zrobił streszczenie.
Reguła: dopisz zatrzymanie: „zadaj mi pytania i nie zaczynaj, dopóki nie odpowiem”. Bez tego model albo uzna, że wie wszystko, albo zapyta tylko dla formy.
7. Wszystko naraz na prawdziwym artykule: streszczenie, strony i zastrzeżenia autorów
Ostatni test zrobiłam na prawdziwym artykule: Schaufeli, Salanova, González-Romá i Bakker o pomiarze zaangażowania i wypalenia, „Journal of Happiness Studies” z 2002 roku. Ten sam prompt o streszczenie, w ChatGPT i w Gemini, z prośbą o numery stron i bez niej. Każde zdanie z odpowiedzi porównałam z PDF.
Oba narzędzia dobrze oddały szkielet: dwie próby (314 studentów i 619 pracowników), model z „rdzeniem wypalenia” i wspólną wariancję między 22% a 38%. Kłopoty zaczęły się w szczegółach, a w pracy dyplomowej liczą się właśnie szczegóły.
Pierwszy kłopot to strony. ChatGPT podawał numery poprawnie, ale według pliku, i sam to zaznaczył. Plik ma 24 strony, a artykuł w czasopiśmie zajmuje strony 71-92. Strona 14 w PDF to strona 84 w czasopiśmie. Kto przepisze do przypisu „s. 14”, poda złą stronę, a recenzent sprawdza strony w wydaniu.
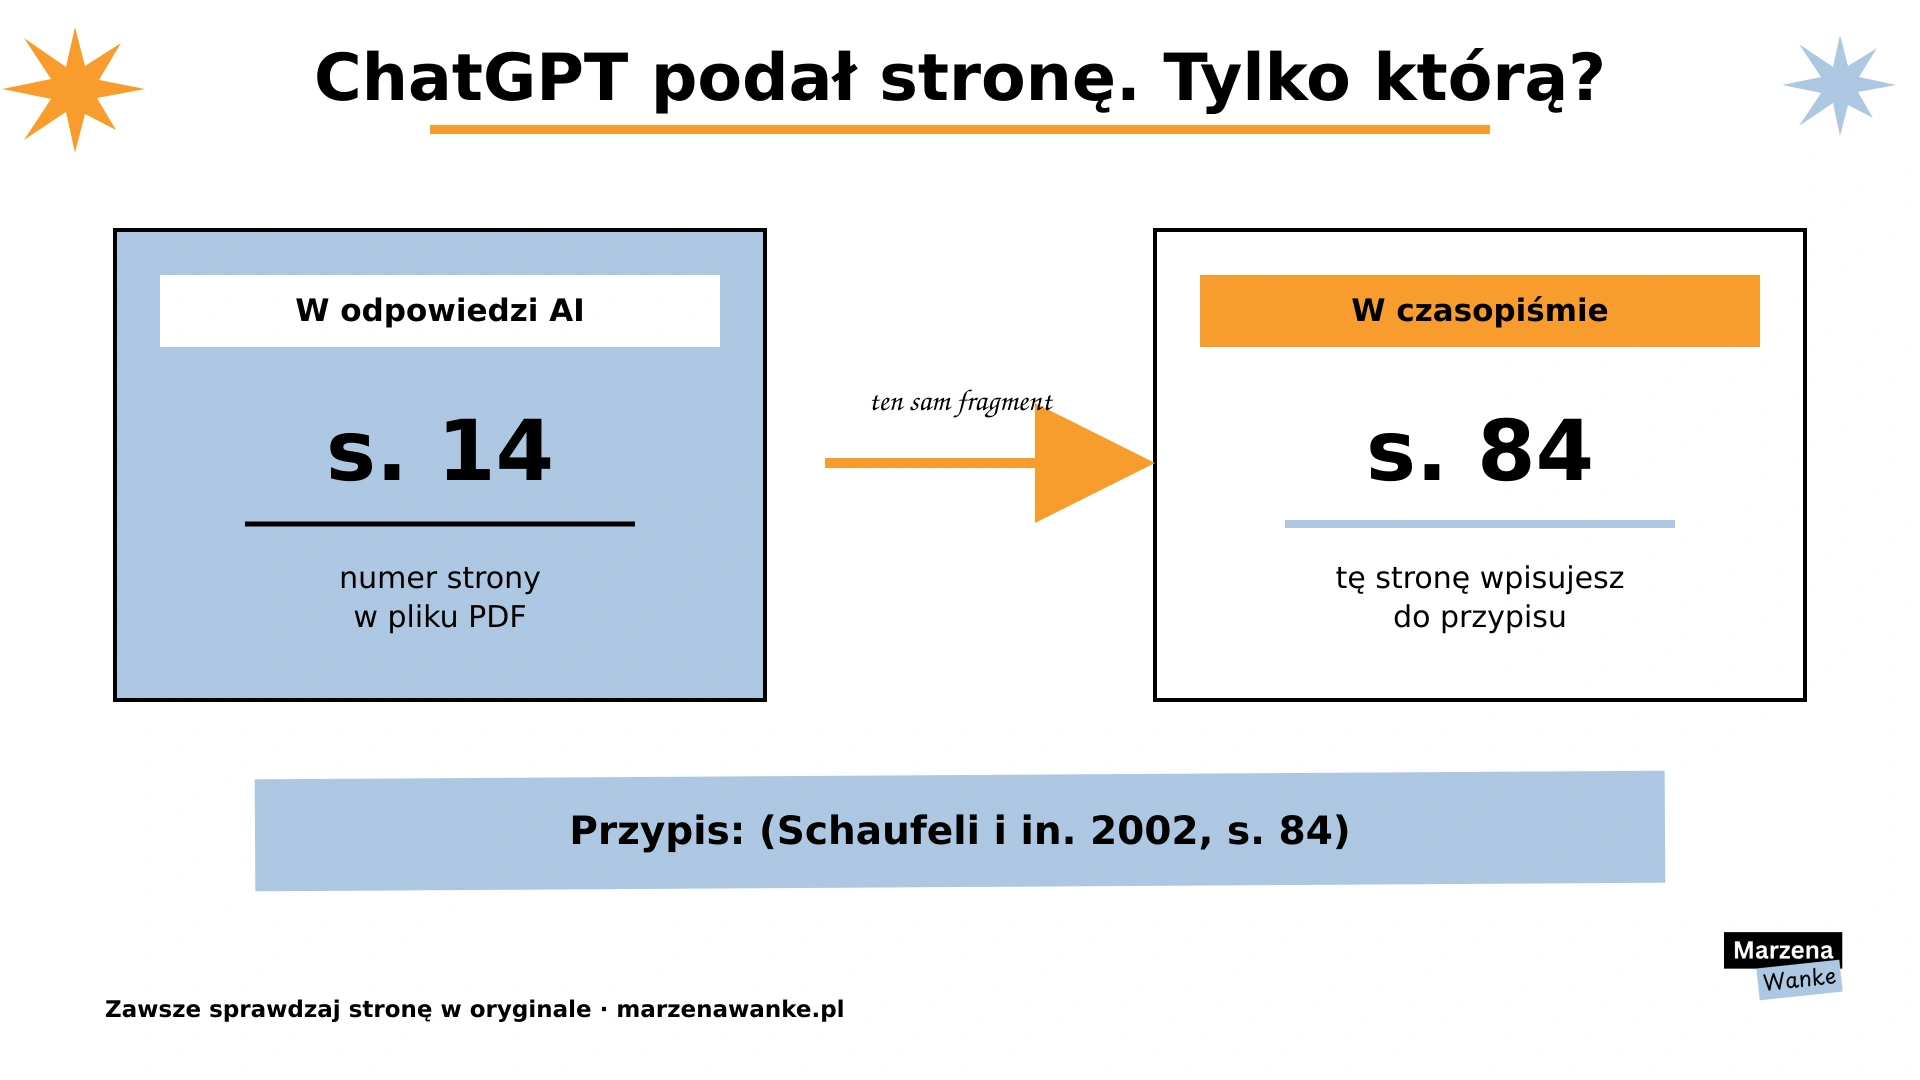
Drugi kłopot jest poważniejszy. Autorzy piszą wprost, że jeden z ich wyników może być artefaktem, bo wszystkie pytania o skuteczność zawodową sformułowano pozytywnie, tak samo jak pytania o zaangażowanie (Schaufeli i in. 2002, s. 86). To zastrzeżenie pojawiło się w jednym streszczeniu na cztery. Paradoksalnie w krótszym ChatGPT, w dłuższym i dokładniejszym już nie. Gemini pominął je w obu wersjach, a w jednej zamiast niego napisał, że wyniki „dowodzą stabilności” narzędzi. Ostrożny wniosek autorów zamienił się w pewnik.
Trzeci kłopot to słowa. Ten sam termin vigor ChatGPT przetłumaczył jako „wigor”, a Gemini jako „werwa”. W pracy obowiązuje termin z polskiej literatury przedmiotu. Wybór modelu niczego tu nie przesądza.
Numer strony z pliku zamiast strony z czasopisma to tylko jeden przykład błędu z moich testów. Było ich więcej: zgubione zastrzeżenie autorów, termin przetłumaczony na dwa sposoby, oceny dopisane mimo zakazu, źródła podane mimo zakazu, przykład skopiowany zamiast nowego pytania, cel z „wpływem” polecony do jednorazowej ankiety i własne propozycje ocenione przez model na „bardzo dobrą”. Żaden z tych błędów nie rzuca się w oczy. Każdy brzmi poprawnie, a recenzent, który zna temat, wyłapie go szybko.
Większość studentów, z którymi pracuję, używa AI do pisania pracy źle. Korzystają z ChatGPT jak z wyszukiwarki Google: wpisują polecenie, biorą pierwszą odpowiedź i idą dalej. Robi tak większość użytkowników, nie tylko studenci. Badacze OpenAI przeanalizowali, do czego ludzie używają ChatGPT, który w połowie 2025 roku dostawał około 18 mld wiadomości tygodniowo. Szukanie informacji znalazło się wśród trzech najczęstszych tematów rozmów, obok praktycznych porad i pisania, a te trzy razem dają prawie 80% wszystkich konwersacji (Chatterji i in. 2025). W Polsce w czerwcu 2025 roku z ChatGPT korzystało 9,3 mln realnych użytkowników (Gemius i PBI 2025). ChatGPT ma czat w nazwie nieprzypadkowo: z modelem się rozmawia. Rozmowa oznacza dopytywanie i podważanie odpowiedzi modelu. Każdą informację, którą od niego dostajesz, trzeba zweryfikować. Kto tego nie robi, popełnia błędy, o których nie ma pojęcia. Weryfikacji tego, co daje AI, uczę między innymi w minikursie „3 błędy”. Na prawdziwych zrzutach ekranu pokazuję tam zmyślone źródła, cytaty i ślady formatowania, których autor pracy sam nie zauważył.
Reguła: proś o numery stron według paginacji wydania, a gdy PDF ma inną numerację, o obie. Każ osobno wypisać wszystkie zastrzeżenia i ograniczenia, które formułują sami autorzy. Każdy cytat i każdą stronę sprawdzasz w oryginale, zanim trafią do pracy. Skąd w ogóle biorą się zmyślone źródła i strony, wyjaśniam we wpisie o tym, dlaczego ChatGPT zmyśla źródła.
Co z tych testów wynika
| Element albo technika | Co zadziałało | Na co uważać |
|---|---|---|
| Element: rola | Recenzent szuka słabych punktów, promotorka tłumaczy na Twoim przykładzie | Bez roli dostajesz odpowiedź z podręcznika |
| Elementy: zadanie, kontekst, format | Kierunki dopasowane do Twoich warunków badania | Zakaz w prompcie nie wyłącza wyszukiwania w sieci |
| Technika: przykłady z komentarzem | Model sam wyprowadza reguły dobrego pytania | Kopiuje przykłady i powtarza ten sam pomysł |
| Technika: łańcuch decyzji z kryteriami | Model sam wyłapuje błąd metodologiczny | Własne propozycje ocenia łagodnie |
| Technika: inżynieria wsteczna | Szablon do ponownego użycia, druga runda łata braki | Szablon potrafi kazać napisać fragment pracy |
| Technika: meta‑polecenie | Model opisuje, jak zrozumiał zadanie | Nie pyta albo nie czeka na odpowiedź |
| Test na artykule | Szkielet artykułu i liczby się zgadzają | Strony pliku zamiast wydania, giną zastrzeżenia autorów |
Najważniejsza zasada: ufaj, ale sprawdzaj
AI wymaga kontroli i weryfikacji na każdym kroku, niezależnie od tego, jak dobry jest prompt. „Ufaj, ale sprawdzaj” to podstawowa zasada pracy ze sztuczną inteligencją. Rolę, kontekst i przykłady dokłada się do promptu właśnie po to, żeby jak najmocniej powstrzymać model przed halucynacjami i oczywistymi błędami. Dobra budowa promptu te błędy ogranicza. Do zera ich nie sprowadza.
Modele mają jeszcze jedną cechę: z góry traktują każde Twoje pytanie jako świetne. W moim teście ten sam mechanizm sprawił, że model ocenił własne propozycje celu pracy na „bardzo dobrą”, choć jedna z nich nie mówiła, co właściwie będzie badane. Jeśli nie sprawdzisz, nikt Ci o tym nie powie, a już na pewno nie model.
Żaden z moich promptów nie zadziałał idealnie za pierwszym razem. Dobry prompt daje wynik przewidywalny i powtarzalny, który i tak wymaga dodatkowej pracy. W pracy dyplomowej ta praca to weryfikacja: każdą stronę, cytat, termin i wniosek sprawdzasz w oryginale, zanim trafi do tekstu. Za każdą odpowiedź modelu, którą przeniesiesz do pracy, odpowiadasz Ty.
Sprawdzania da się nauczyć na sucho. Hubert Adamczyk na webinarze o AI w warsztacie badacza pokazał uczestnikom celowo złą odpowiedź modelu: „Generatywna AI znacząco poprawiła jakość pracy naukowej, ponieważ automatyzuje analizę literatury, eliminuje błędy metodologiczne i pozwala szybciej publikować artykuły. Uczelnie powinny jak najszybciej wdrożyć AI we wszystkich obszarach badań i dydaktyki, ponieważ jest to rozwiązanie obiektywne, efektywne i neutralne”. Do takiego tekstu zadajesz cztery pytania: co brzmi zbyt pewnie jak na brak źródła, co jest tylko uproszczeniem, czego tu brakuje i kto powinien to zweryfikować (Adamczyk 2026, slajd 29). Uczestniczki rozłożyły ten fragment w kilka minut. Jedna zwróciła uwagę, że model, który zmyśla źródła, nie może „eliminować błędów metodologicznych”, druga nazwała „obiektywne, efektywne i neutralne” po prostu nieprawdą. Twierdzenia o faktach, które nie mają przypisu, sprawdzisz dodatkowo w serwisach weryfikujących informacje, takich jak Demagog, Google Fact Check Tools czy Reuters Fact Check (Adamczyk 2026, slajd 34). Zrób to ćwiczenie z każdym akapitem, który dostajesz od modelu. Jeśli czytasz go i nie masz żadnych zastrzeżeń, przeczytaj jeszcze raz.
Jak sprawdzić, czy ChatGPT nie zmyśla?
Zadaj to samo pytanie w dwóch innych modelach i sprawdź każde nazwisko w bazie naukowej, zanim wpiszesz je do pracy. McMichael dostała to pytanie z sali: jak student ma oceniać trafność odpowiedzi AI, skoro sam nie jest ekspertem. Jej metoda jest prosta. To samo pytanie w ChatGPT, Gemini i Claude, potem porównanie. Tam, gdzie modele się różnią, jest miejsce do sprawdzenia w źródłach. Tam, gdzie zgadzają się co do nazwiska, którego nie ma w Google Scholar, jest halucynacja, którą trzy modele powtórzyły zgodnie.
Do rozmów o własnych materiałach polecała NotebookLM od Google, bo odpowiada tylko na podstawie wgranych plików i pokazuje, z którego fragmentu wziął odpowiedź. Wgrywasz pięć artykułów do przeglądu literatury, pytasz, jak każdy z autorów definiuje pojęcie, i dostajesz odpowiedź z odnośnikiem do strony. Model nie może wymyślić szóstego autora, bo go nie wgrałeś.
Z polskimi źródłami modele radzą sobie gorzej niż z anglojęzycznymi, bo widziały ich mniej. W jednej z prac, które poprawiałam w tym roku, na 49 pozycji bibliografii 10 nie istniało wcale, a kolejne 11 miało błędy: istniejący autor i zmyślony tytuł, właściwy tytuł i niewłaściwe wydawnictwo. Praca wyglądała na pierwszy rzut oka porządnie. Promotor, który zna literaturę swojego tematu, wyłapuje takie pozycje bez żadnego narzędzia.
Mój Tip: wpisz nazwisko autora i tytuł w cudzysłowie do Google Scholar albo BazEkon. Zero wyników oznacza zero przypisu.
Reszta to zwykła krytyka źródeł, którą Byłeń nazywa warunkiem określenia ich przydatności (Byłeń 2017, s. 70). Metoda analizy i krytyki piśmiennictwa, jego zdaniem najczęściej stosowana w pracach dyplomowych, polega na ocenie treści publikacji na tle wiedzy już istniejącej (Byłeń 2017, s. 152). AI tej oceny nie zrobi za Ciebie, może najwyżej podsunąć, od czego zacząć. Jak szybko przejść od podpowiedzi AI do prawdziwych publikacji, pokazałam w tekście o źródłach do pracy licencjackiej w 30 minut.
Czy JSA wykryje, że rozmawiałeś z ChatGPT?
JSA analizuje wyłącznie tekst pracy. Historii czatów nie widzi, więc jeśli w pracy nie ma zdań z ChatGPT, nie ma czego oznaczać. Od lutego 2024 r. Jednolity System Antyplagiatowy ma dodatkową analizę SI. Działa na podstawie perplexity, czyli przewidywalności ciągów słów: fragmenty zbyt regularne trafiają do osobnej zakładki, którą widzi promotor. Dokumentacja OPI zastrzega, że każde narzędzie tego typu ma margines błędu w obie strony, a system nie wydaje wiążących rozstrzygnięć. Wynik uruchamia rozmowę z promotorem. Wyrok zapada dopiero po niej. Byłeń pisze to samo o współczynnikach podobieństwa: przekroczenie progu nie oznacza automatycznie plagiatu (Byłeń 2017, s. 201).
Pięć promptów z tego wpisu nie produkuje tekstu do wklejenia, więc kwestia wykrywalności ich nie dotyczy. Dotyczy natomiast regulaminu Twojej uczelni. Zarządzenia uczelni z lat 2023-2025 zbiegły się do jednego wzorca, który widać w dokumentach UW, Uniwersytetu Medycznego w Łodzi i UE w Katowicach: AI wolno używać jako narzędzia pomocniczego, nie do generowania pracy; użycie uzgadniasz z promotorem; opisujesz je w pracy, często z nazwą narzędzia i zakresem; za treść i źródła odpowiadasz Ty, a nieujawnione użycie bywa traktowane jak plagiat. Szczegóły różnią się między wydziałami, więc sprawdź własne zarządzenie przed pierwszą rozmową z modelem, nie po oddaniu pracy. O tym, gdzie przebiega granica między wsparciem a plagiatem, pisałam w tekście o pisaniu pracy z AI etycznie.
Najczęstsze błędy przy promptach do pracy licencjackiej
Pięć błędów, które widzę najczęściej, i każdy z nich kończy się tym samym: student nie umie obronić własnej pracy.
- „Napisz mi całość”. Najkrótsza droga do pracy, której nie znasz. W tej samej pracy z 49 pozycjami bibliografii w rozdziale badawczym został fragment: „w miejscu wartości liczbowych należy wprowadzić rzeczywiste wyniki z ankiety”. Model zostawił instrukcję dla autora, autor jej nie przeczytał, bo nie czytał własnej pracy. Ankiety nikt nie przeprowadził.
- Brak kontekstu w promptcie. Jeśli AI nie zna Twojej pracy, zgaduje, i robi to w bardzo przekonujący sposób. Pytanie „co to jest motywacja” daje ogólnik z podręcznika do liceum. Pytanie „piszę pracę o motywacji płacowej w firmie logistycznej, promotor oczekuje ujęcia Pocztowskiego” daje odpowiedź, z którą można pracować.
- Bibliografia z czatu. Model podaje pięć pozycji z autorami, rokiem i wydawnictwem. Część z nich nie istnieje, przy polskich źródłach częściej niż przy angielskich. Każdą sprawdzasz w Google Scholar, BazEkon albo katalogu biblioteki, zanim trafi do przypisu.
- Jeden czat do wszystkiego. W długiej rozmowie odpowiedzi robią się ogólne i zaczynają się powtarzać, bo czat się zapycha. Rozwiązanie: nowa rozmowa w tym samym projekcie, w którym trzymasz temat, cel i wytyczne promotora. Kontekst zostaje, jakość wraca.
- Parafrazowanie parafraz. Maciej, który pisał do mnie na starcie pracy, dostał od ChatGPT radę, że musi parafrazować jego parafrazy, bo inaczej JSA zarzuci mu na podstawie stylometrii, że nie pisał sam. To pętla bez końca. Tekst, który wychodzi z Twoich notatek, nie potrzebuje parafrazowania, bo od początku jest Twój.
Co komisja sprawdza na obronie oprócz regulaminu
Komisja sprawdza, czy wiesz, co masz w pracy. Sposób, w jaki do tego doszedłeś, interesuje ją mniej. McMichael zakończyła wykład zdaniem, które przełożyłabym na każdą obronę w Polsce: chodzi nie o ochronę uczciwości akademickiej, ale o pogłębienie uczciwości intelektualnej. Uczciwość akademicka, ta z regulaminów i kodeksów etyki, kończy się na pytaniu, czy złamałeś zasady. Intelektualna dotyczy innego pytania: czy rozumiesz własny tekst. Pięć promptów z tego wpisu nie odpowie za Ciebie na to pytanie, ale sprawi, że będziesz miał odpowiedź. Tak rozumiem etyczne korzystanie z AI: ma rozwijać Twoje myślenie, a nie je zastępować. AI to booster, nie autor.
Prompty do pracy licencjackiej: najczęstsze pytania (FAQ)
Czy ChatGPT napisze całą pracę licencjacką?
Napisze tekst o długości pracy licencjackiej, ale nie napisze Twojej pracy. Nie zna wytycznych promotora, regulaminu wydziału ani firmy, w której robisz badania, a jego bibliografia w części nie istnieje. Praca napisana w ten sposób kończy się na obronie, nie w JSA.
Ile promptów potrzeba na całą pracę licencjacką?
Nie ma takiej liczby, bo prompt nie jest jednostką pracy. Pięć promptów z tego wpisu, użytych po jednym na etap, daje więcej niż pięćdziesiąt szablonów typu „napisz podrozdział”. Liczy się to, co zapisujesz po każdej rozmowie.
Czy używanie promptów do pracy licencjackiej jest legalne?
Tak, jeśli regulamin Twojej uczelni nie zakazuje danego zastosowania i jeśli w pracy nie ma tekstu wygenerowanego przedstawionego jako Twój. Rozmowa z modelem o tym, czego nie rozumiesz, nie narusza żadnego regulaminu. Wklejenie odpowiedzi modelu do rozdziału narusza większość z nich.
Czy trzeba wpisać ChatGPT do bibliografii?
Jeśli cytujesz odpowiedź modelu jako źródło, tak, według wytycznych stylu, w którym piszesz. Jeśli używasz go do zadawania sobie pytań, nie ma czego cytować, bo w pracy nie ma jego tekstu. Sprawdź, czy uczelnia wymaga osobnego oświadczenia o użyciu AI.
Który model jest najlepszy do nauki, a nie do pisania pracy magisterskiej?
Do promptów z tego wpisu wystarczy dowolny z trzech dużych: ChatGPT, Claude albo Gemini. Do pracy na własnych plikach NotebookLM, bo odpowiada tylko na podstawie tego, co wgrasz. Różnice między modelami są mniejsze niż różnica między promptem, który pisze, a promptem, który uczy.
Czy prompty do pracy magisterskiej różnią się od promptów do licencjackiej?
Zasady są te same: rola, kontekst, przykłady, kryteria i sprawdzenie w oryginale. Zmienia się kontekst, który wpisujesz. Przy pracy magisterskiej podaj, że to magisterka, jaki jest problem badawczy i hipotezy oraz jakiej analizy danych wymaga promotor. Model bez tej informacji zakłada poziom średni i odpowiada ogólnie.
Czy ten sam prompt działa tak samo w ChatGPT i w Gemini?
Nie zawsze. W moim teście na tę samą prośbę o dopytanie ChatGPT odpisał, że nie potrzebuje informacji, a Gemini zadał pytanie i nie poczekał na odpowiedź. Przy streszczeniu artykułu oba narzędzia inaczej przetłumaczyły ten sam termin i różniły się tym, które zastrzeżenia autorów zachowały. Jeśli zmieniasz narzędzie, sprawdź prompt na krótkim fragmencie, zanim użyjesz go do całego rozdziału.
Prompty masz, a nie wiesz, od którego etapu zacząć? Mapa Startu prowadzi przez 7 kroków od pustej strony do obrony, z planerem do wydruku.
Źródła wykorzystane w tym wpisie
- Adamczyk H., AI w warsztacie badacza i dydaktyka. Inspiracje, dobre praktyki i zagrożenia, wystąpienie, 22 maja 2026, slajdy 29, 34.
- Byłeń S., Metodyka pisania pracy dyplomowej na kierunku logistyka, Wydawnictwo Społecznej Akademii Nauk, Łódź, Warszawa 2017.
- Chatterji A., Cunningham T., Deming D.J., Hitzig Z., Ong C., Shan C.Y., Wadman K., How People Use ChatGPT, NBER Working Paper nr 34255, National Bureau of Economic Research, wrzesień 2025, nber.org [dostęp: 6.10.2026].
- Gemius, PBI, Jak polscy internauci korzystają z ChatGPT? Wyniki raportu, oprac. B. Wójcik, 2025, gemius.com [dostęp: 6.10.2026].
- Gietka N., Praktyczne wykorzystanie narzędzi GenAI w edukacji. Od podstawowych do zaawansowanych narzędzi, szkolenie, Fundacja na rzecz promocji nauki i rozwoju TYGIEL, Lublin 2026, slajd „Jak promptować?”, cz. B, 13:06-13:24.
- McMichael K., From Task Completion to Deep Learning: Helping Students Use AI as a Learning Partner, wykład na konferencji AI and the Future of Education, American Public University System.
- Ośrodek Przetwarzania Informacji, Analiza użycia sztucznej inteligencji, baza wiedzy JSA, aktualizacja 8.07.2025, jsa-cp.opi.org.pl.
- Ośrodek Przetwarzania Informacji, JSA: promotor sprawdzi, czy student korzystał z technologii ChatGPT, komunikat z 15.02.2024, opi.org.pl.
- Schaufeli W.B., Salanova M., González-Romá V., Bakker A.B., The Measurement of Engagement and Burnout: A Two Sample Confirmatory Factor Analytic Approach, „Journal of Happiness Studies” 2002, nr 3, s. 71-92.
- Uchwała nr 98 Uniwersyteckiej Rady ds. Kształcenia Uniwersytetu Warszawskiego z 2023 r.; Zarządzenie nr 89/2025 Rektora Uniwersytetu Medycznego w Łodzi; Zarządzenie nr 92/25 Rektora Uniwersytetu Ekonomicznego w Katowicach.
- Wanke M., Metoda 3K na dobry prompt, film YouTube, 2026, youtube.com.
- Wanke M., Napisz swoją pracę z AI lepiej niż 95% studentów, film YouTube, 2026, youtube.com.
- Wrycza-Bekier J., Kreatywna praca dyplomowa. Jak stworzyć fascynujący tekst naukowy, Helion (Septem), Gliwice 2011.
Testy w ChatGPT (czat tymczasowy) i Gemini przeprowadziłam 6 października 2026 roku.