Czy detektor AI się myli? Cztery narzędzia, jeden tekst, cztery różne wyniki
W skrócie: Czy detektor AI się myli? Tak, i to w obie strony. Cztery narzędzia sprawdzone na jednym tekście z 1776 roku dały cztery różne werdykty, od 97,93 procent treści wygenerowanej przez AI do spokojnego „napisał to człowiek”. Uniwersytet Vanderbilta przeliczył deklarowany jeden procent fałszywych alarmów na własną skalę i wyłączył moduł detekcji. Dla polszczyzny istnieje jeden publiczny pomiar i nie dotyczy narzędzi, z którymi masz kontakt na uczelni. Poniżej liczby, nazwy narzędzi i to, co z nich wynika dla Twojej pracy.
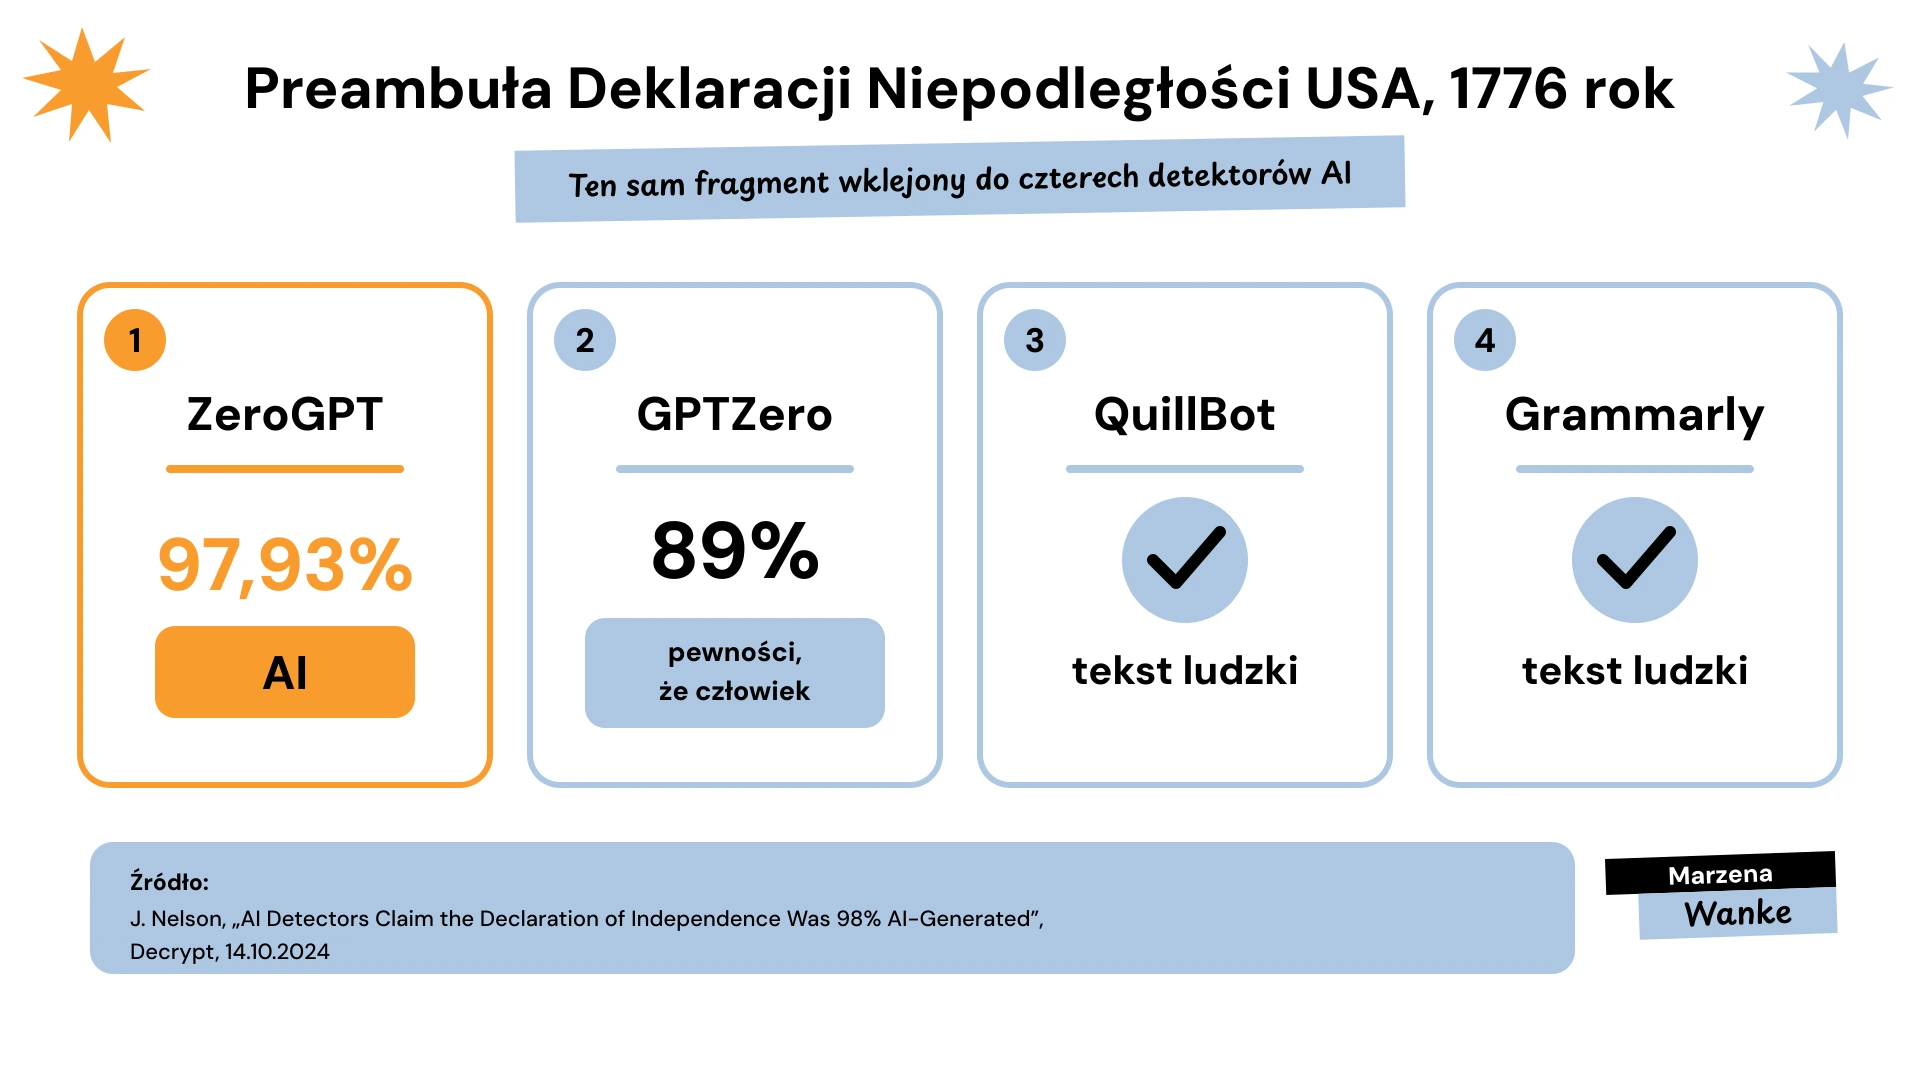
W październiku 2024 roku redakcja serwisu Decrypt wkleiła do czterech detektorów AI preambułę Deklaracji Niepodległości Stanów Zjednoczonych. Tekst z 1776 roku. ZeroGPT orzekł 97,93 procent treści wygenerowanej przez sztuczną inteligencję. GPTZero w tej samej próbie dał 89 procent pewności, że pisał człowiek. QuillBot i Grammarly nie miały wątpliwości, że autorem jest człowiek (Nelson 2024).
Zanim więc zapytasz, czy detektor mógł się pomylić na Twoim rozdziale teoretycznym, zobacz, że cztery narzędzia nie potrafią dojść do zgody w sprawie tekstu, który ma dwa i pół wieku.
Na konsultacjach słyszę to pytanie w dwóch wersjach. Pierwsza brzmi „czy mnie wykryją”, druga „czy mogą mnie oskarżyć, chociaż pisałam sama”. Druga jest trudniejsza i o niej jest ten wpis.
Cztery detektory AI, jeden tekst, cztery różne wyniki
Najciekawsze w tych narzędziach jest to, jak daleko od siebie potrafią się rozejść na jednym tekście. Wynik zależy wtedy bardziej od wybranego programu niż od osoby, która pisała.
Tak wyglądał test Decrypt na preambule Deklaracji Niepodległości:
| Narzędzie | Werdykt dla tekstu z 1776 roku |
|---|---|
| ZeroGPT | 97,93% treści wygenerowanej przez AI |
| GPTZero | 89% pewności, że pisał człowiek |
| QuillBot | tekst ludzki |
| Grammarly | tekst ludzki |
Źródło: J. Nelson, AI Detectors Claim the Declaration of Independence Was 98% AI-Generated, „Decrypt”, 14 października 2024.
W tym samym materiale redakcja sprawdziła jeszcze opowiadanie „The Machine Stops” E.M. Forstera z 1909 roku, razem z jego przeróbką zrobioną przez ChatGPT, i wyniki rozeszły się podobnie. GPTZero poradził sobie wzorowo: oryginał dostał 97 procent „człowiek”, wersja AI 95 procent „AI”. QuillBot nie zobaczył między nimi żadnej różnicy. Obu dał zero. ZeroGPT uznał za wygenerowane praktycznie w całości i jedną, i drugą.
Rok później podobny test zrobiła redakcja The Dallas Express, tym razem na trzech dokumentach z Teksasu z 1836 roku. ZeroGPT ocenił Deklarację Niepodległości Teksasu na 86,54 procent AI, a mowę inauguracyjną Sama Houstona i przysięgę Davy’ego Crocketta z tego samego roku na zero procent (Jones 2025). Jedno narzędzie, jeden rok, trzy dokumenty, trzy zupełnie różne odpowiedzi.
Najgłośniejszy przypadek jest starszy. W lipcu 2023 roku Benj Edwards z Ars Technica opisał, że GPTZero uznaje fragmenty Konstytucji Stanów Zjednoczonych za tekst napisany w całości przez AI, ZeroGPT klasyfikuje je jako „AI/GPT Generated”, a klasyfikator OpenAI odpowiada „unclear” (Edwards 2023). Autor dodał, że to samo dzieje się z fragmentami Biblii. Wyjaśnienie podał twórca GPTZero: Konstytucja trafiała wielokrotnie do danych treningowych modeli językowych, więc jest dla nich tekstem skrajnie przewidywalnym.
Dlaczego przewidywalność w ogóle jest tu miarą, rozbieram na czynniki pierwsze w tekście o tym, czy JSA wykrywa ChatGPT. Tutaj wystarczy jedno zdanie. Detektory analizują teksty pod kątem dwóch rzeczy: przewidywalności kolejnych słów i zmienności długości zdań, po angielsku perplexity i burstiness. Autorstwo zostaje poza zasięgiem takiego pomiaru.
Mój Tip: Gdy ktoś przysyła Ci zrzut ekranu z detektora, zadaj dwa pytania: które to narzędzie i jak długi fragment sprawdzał. OpenAI przy własnym klasyfikatorze pisało wprost, że wyniki są „very unreliable” poniżej tysiąca znaków, a 20 lipca 2023 roku wycofało go „due to its low rate of accuracy” (OpenAI 2023). Producent z najlepszym możliwym dostępem do modelu odpuścił po niecałym półroczu.
Nie tylko teksty historyczne. Kto dostaje fałszywy alarm z detektora AI
Fałszywy alarm nie spada z nieba losowo. Zbiera go tekst przewidywalny, a przewidywalny bywa też ten, który powstawał tydzień nad książką.
Janelle Shane pisze o sztucznej inteligencji od lat i wydała o niej książkę. Wkleiła fragment własnej książki do dwóch detektorów; jeden ocenił jej tekst jako „very likely to be AI-written”. Jej wniosek trafił do tytułu artykułu w „Fortune”: „Don’t use AI detectors for anything important” (Pastis 2023).
Na panelu amerykańskiego systemu uczelnianego APUS padła obserwacja, która idzie w tym samym kierunku. Haley Hawthorne, koordynatorka spraw dyscyplinarnych w tej uczelni, zwróciła uwagę, że dorośli w spektrum autyzmu piszą wzorcami brzmiącymi bardziej „AI-owo”, bo model też generuje tekst wzorcami. Gdy detektory wchodziły na rynek, w tej grupie miały według niej bardzo wysoki wskaźnik błędu i oznaczały tekst człowieka jako AI (Hawthorne 2025, [45:58]). To obserwacja osoby rozpatrującej takie sprawy zawodowo, nie badanie z liczbami, ale mechanizm pasuje do publikacji: narzędzie reaguje na regularność.
Dwie pozostałe grupy ryzyka mają już pokrycie w badaniach i opisałam je razem z liczbami w tekście o filarze serii: osoby piszące w drugim języku oraz teksty przepuszczone przez tłumaczenie maszynowe. Tam też znajdziesz zdanie z dokumentacji JSA o tym, dlaczego definicje i przepisy prawne bywają oznaczane bez żadnego udziału AI.
Jest w tym pewna ironia, którą warto sobie nazwać. Największe ryzyko fałszywego alarmu zbiera osoba pisząca poprawnie, rzeczowo i bez fajerwerków, czyli dokładnie tak, jak wymaga od Ciebie promotor.
Ile w liczbach znaczy jeden procent pomyłek detektora AI
Jeden procent brzmi jak nic. Przestaje brzmieć jak nic, kiedy pomnożysz go przez liczbę prac składanych w ciągu roku.
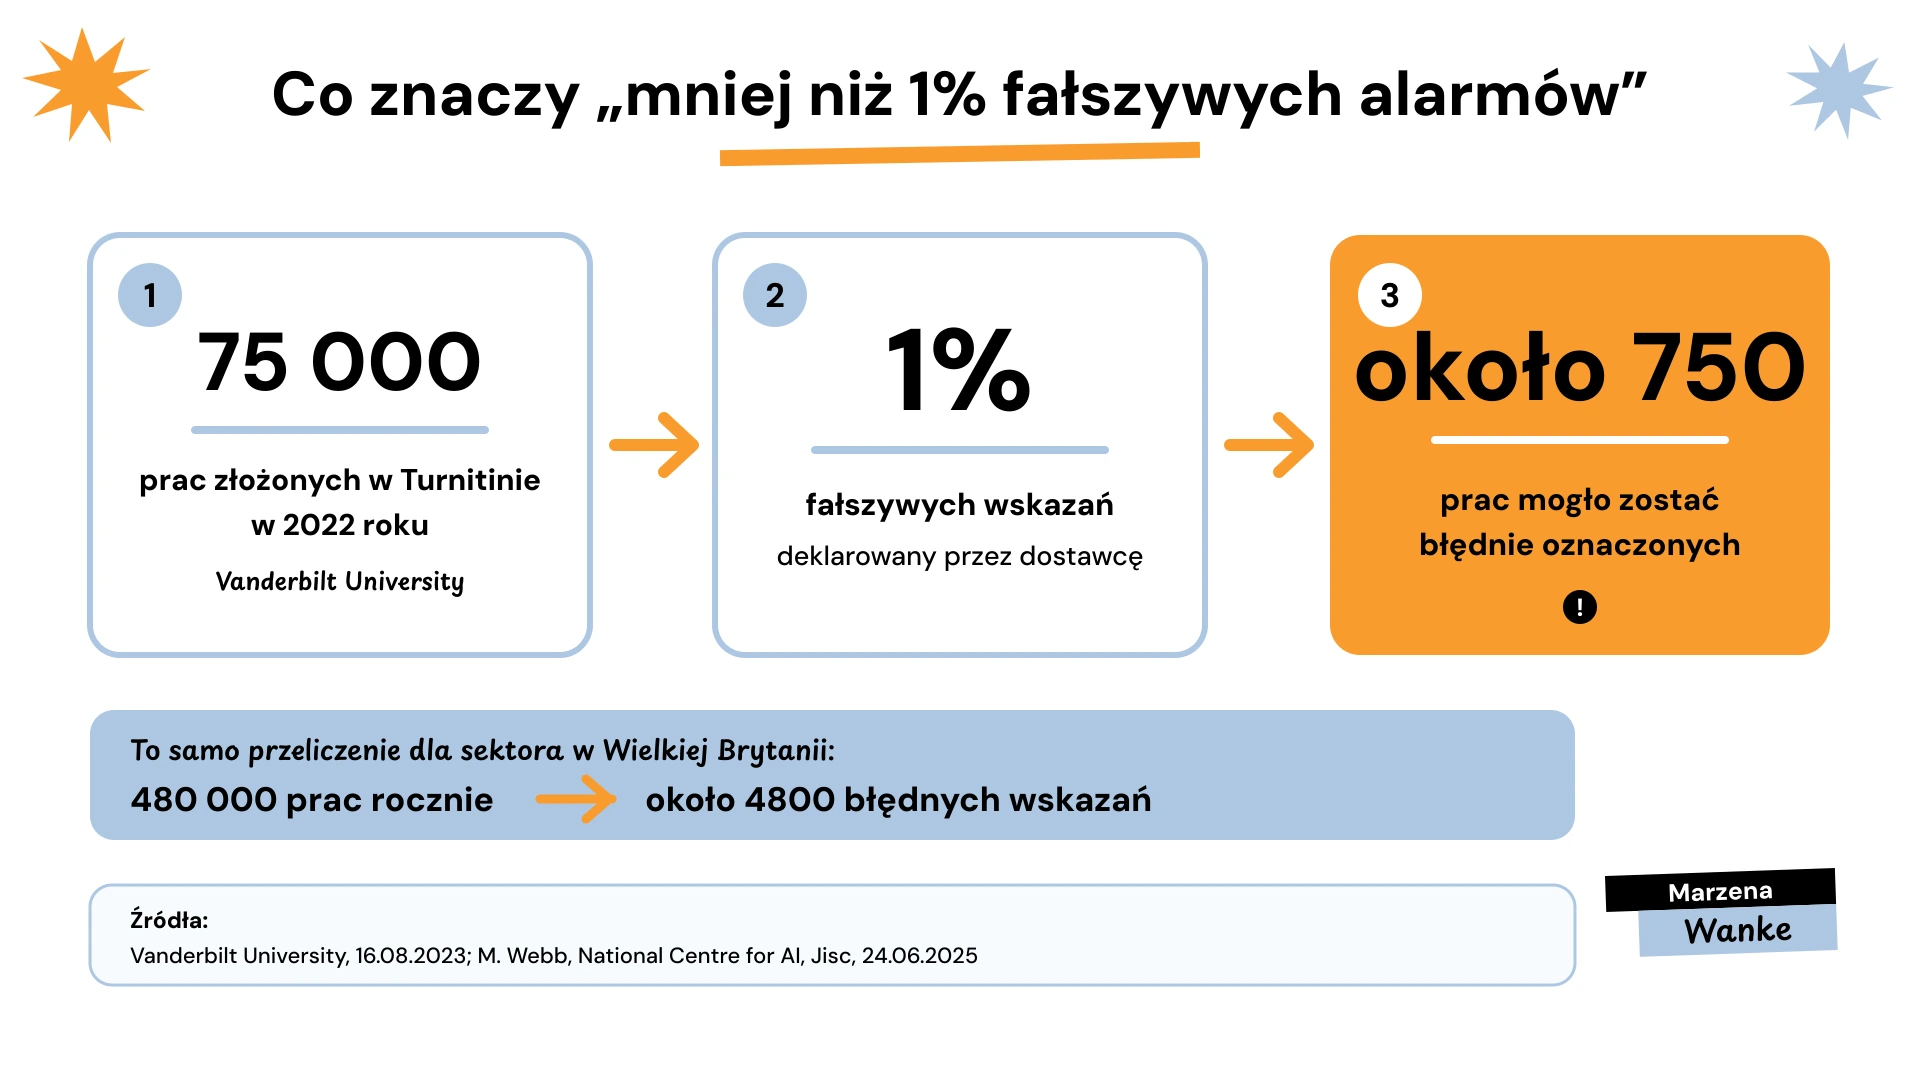
Zrobił to Uniwersytet Vanderbilta w sierpniu 2023 roku. Turnitin deklarował wtedy mniej niż jeden procent fałszywych alarmów. Uczelnia zestawiła to z własną statystyką, czyli 75 tysiącami prac złożonych w 2022 roku, i policzyła, że przy takim wskaźniku „around 750 student papers could have been incorrectly labeled” jako zawierające treść napisaną przez AI. Moduł detekcji AI w Turnitinie został wyłączony. W uzasadnieniu padły cztery powody: ta liczba, ustalenie, że detektory częściej oznaczają jako AI teksty osób, dla których angielski nie jest pierwszym językiem, brak przejrzystości oprogramowania i prywatność prac studenckich przekazywanych podmiotowi trzeciemu (Vanderbilt University 2023).
Ocena ogólna w tym samym komunikacie brzmi mocniej niż wszystko, co o detektorach piszą firmy, które je sprzedają:
Fundamentally, AI detection is already a very difficult task for technology to solve (if it is even possible) and this will only become harder as AI tools become more common and more advanced.
Vanderbilt University, Guidance on AI Detection and Why We’re Disabling Turnitin’s AI Detector, Brightspace, 16 sierpnia 2023.
To samo przeliczenie dla całego sektora zrobił Michael Webb z brytyjskiego National Centre for AI przy Jisc. Przy 480 tysiącach prac ocenianych rocznie i tym samym jednym procencie wychodzi około 4800 fałszywych oskarżeń w roku.
Jest jeszcze liczba, o której producent mówi najciszej. Deklaracja „poniżej jednego procenta” dotyczy całych dokumentów i tylko tych, w których wykryto co najmniej 20 procent treści AI. Na poziomie pojedynczego zdania Turnitin podaje około czterech procent (Turnitin 2023). Promotor patrzy właśnie na podświetlone zdania, nie na wynik zbiorczy.
Ważne!
Wiarygodność narzędzi do wykrywania tekstu wygenerowanego przez modele językowe bywa kwestionowana również przez same instytucje akademickie. Uniwersytet Vanderbilta, uzasadniając wyłączenie modułu detekcji sztucznej inteligencji, wskazał, że przy deklarowanym przez dostawcę poziomie jednego procenta fałszywych wskazań i 75 tysiącach prac złożonych w 2022 roku około 750 prac studenckich mogłoby zostać błędnie oznaczonych jako zawierające treść wygenerowaną przez sztuczną inteligencję (Vanderbilt University 2023). Analogiczne przeliczenie dla sektora szkolnictwa wyższego w Wielkiej Brytanii, przy 480 tysiącach ocenianych prac rocznie, daje około 4800 błędnych wskazań w skali roku (Webb 2025). Jednocześnie dla języka polskiego nie opublikowano dotąd pomiaru skuteczności komercyjnych narzędzi detekcji; jedyne dostępne dane pochodzą z benchmarku obejmującego siedem języków Europy Środkowej i dotyczą detektorów badawczych, nie rozwiązań stosowanych w procedurach uczelnianych (Macko, Kopal 2025).
Przypis: Vanderbilt University, Guidance on AI Detection and Why We’re Disabling Turnitin’s AI Detector, Brightspace, 16 sierpnia 2023; M. Webb, AI Detection and assessment: an update for 2025, National Centre for AI, Jisc, 24 czerwca 2025; D. Macko, J. Kopal, CEAID: Benchmark of Multilingual Machine-Generated Text Detection Methods for Central European Languages, preprint arXiv:2509.26051, wrzesień 2025.
Piszesz z ChatGPT? Liczby wyżej mówią o tym, czego detektor nie rozstrzyga. Problem zaczyna się gdzie indziej: przy źródłach, których nie ma, i przy cytatach, których nikt nie napisał. Trzy błędy, które promotor widzi od razu, pokazuję na prawdziwych zrzutach ekranu w trzech mailach.
„Mnie się udało”. Drugi biegun tej samej rozmowy
Pod filmami o antyplagiacie stoją obok siebie dwa przeciwne przekonania i oba opierają się na jednym przypadku.
Z jednej strony komentarze w rodzaju „jsa nie wyłapuje, moja koleżanka pisząc całą pracę z chatem i miała 1%”. Obok tego: „Nie istnieje narzędzie do sprawdzania AI i potwierdził mi to doktor. Wszystko opiera się o przypuszczenia, na podstawie słownictwa, np. »kluczowy«”. Z drugiej strony, pod tym samym filmem: „Może przejdzie w Pcimiu Dolnym ale na pewno nie w liczących się uniwersytetach”.
W tym pierwszym komentarzu siedzi pomyłka, którą widzę u Was regularnie. Ten „1 procent” to wynik badania podobieństwa, czyli porównania pracy z bazami tekstów. Analiza SI jest osobną częścią raportu i nie wchodzi do wyników ogólnych. Niski procent podobieństwa nie mówi o użyciu AI absolutnie nic, a przy pracy zbudowanej na nieistniejących źródłach będzie nawet niższy niż zwykle, bo taki tekst nie ma się z czym pokryć.
Drugi biegun wygląda tak. Jeden z czytelników napisał mi, że ChatGPT poradził mu parafrazować własne parafrazy, bo inaczej JSA zarzuci mu na podstawie stylometrii, że nie pisał sam. Model wymyślił mechanizm, którego w dokumentacji systemu nie ma, a człowiek został z lękiem i planem pracy na dwa dodatkowe wieczory.
Obie strony robią to samo: wnioskują o całym systemie z jednego przypadku. Koleżanka z jedynką w raporcie nie mówi nic o rozkładzie, tak samo jak jedna osoba wezwana na rozmowę.
Mój Tip: Nie uśredniaj wyników z trzech darmowych detektorów. Każdy ma inny próg i inny zbiór treningowy, więc średnia z trzech nieporównywalnych liczb nie jest bliżej prawdy. Jest tylko trudniejsza do podważenia w rozmowie, bo brzmi jak pomiar.
Część tych historii kończy się na narzędziu, które obiecuje przepisać tekst tak, żeby detektor zamilkł. Co taki humanizer robi z pracą i czego z niej nie usuwa, sprawdzam osobno przy pytaniu, czy humanizer AI działa.
Jak skuteczne są detektory AI na tekstach po polsku
Dla polszczyzny istnieje jeden publiczny pomiar i nie dotyczy narzędzi, z którymi masz kontakt na uczelni.
To benchmark CEAID z 2025 roku. Autorzy sprawdzili, jak różne detektory identyfikują teksty generowane przez modele językowe, po angielsku LLM, w siedmiu językach Europy Środkowej, na 132 168 próbkach. Najlepszy dostrojony detektor osiągnął dla polskiego AUC ROC na poziomie 0,977, czyli wynik bardzo dobry, porównywalny z czeskim i węgierskim (Macko i Kopal 2025).
Zanim jednak potraktujesz to jako dowód, że system i tak wszystko wyłapie, dwa zastrzeżenia zmieniają sens tej liczby. Po pierwsze, mowa o detektorach badawczych, dostrajanych na zbiorze treningowym pod konkretne zadanie, a nie o komercyjnym narzędziu ani o module w systemie antyplagiatowym. Po drugie, AUC ROC nie jest tym samym co dokładność i nie mówi, ile fałszywych alarmów dostaną konkretni ludzie przy konkretnym progu.
Dla JSA nie opublikowano żadnych danych o dokładności modułu analizy SI: ani odsetka fałszywych wskazań, ani czułości, ani testów walidacyjnych. Operator podaje za to wprost w bazie wiedzy JSA, że wszystkie narzędzia tego typu mają swój margines błędu i że system nie dokonuje wiążących ustaleń dotyczących wykroczeń (OPI PIB).
Jedna rzecz z tego samego benchmarku warta jest zapamiętania, bo rozbraja popularną radę. Parafrazowanie nie obniżyło skuteczności detektorów dostrojonych; degradację przyniosła dopiero podmiana znaków na wizualnie identyczne homoglify, czyli operacja na kodowaniu pliku, nie na tekście. O tym, dlaczego takie triki są najgorszą drogą, pisałam przy okazji pytania, czy da się oszukać antyplagiat.
Po co promotorowi detektor AI, jeśli i tak widzi
Do rozmowy o autorstwie nie potrzeba żadnego narzędzia. Wystarczy, że promotor sprawdzi jeden przypis.
Na wspomnianym panelu Jenny Hawkins, odpowiadająca w APUS za prawa studenta, oszacowała, że mniej więcej w dziewięciu przypadkach na dziesięć w pracy znajdzie się coś innego niż wynik detektora: źródło z błędnym autorem albo datą, pozycja cytowana w tekście, której nie ma w bibliografii, fragment bez żadnego przypisu. Opisała pracę bez ani jednego przypisu w tekście i postawiła sprawę wprost. Nie da się wtedy powiedzieć „bez wątpienia użył AI”, da się natomiast powiedzieć, że to plagiat, bo nie podano atrybucji do materiału źródłowego (Hawkins 2025, [29:13]). Jej koleżanka z panelu ujęła to krócej:
I have yet to see an AI-generated paper that did not have academic integrity concerns in it.
H. Hawthorne, wypowiedź w panelu Generative AI, Academic Integrity and the Question of Evidence, konferencja „AI and the Future of Education”, APUS, 16-17 października 2025, [33:17].
Z mojej perspektywy po siedemnastu latach pracy ze studentami wygląda to tak samo. Detekcja jest najsłabszym z problemów osoby, która pisała z czatem. Wcześniej pojawia się obrona, na której trzeba znać własny tekst, i bibliografia, w której połowa pozycji nie istnieje. Co dokładnie widzi promotor w raporcie i co z tego może zrobić, rozkładam w tekście o tym, jak działa JSA.
Nikt Wam nie pokazuje, jak używać AI tak, żeby ta rozmowa w ogóle nie miała tematu. Seminarium tego nie obejmuje, a poradniki z internetu kończą się na „parafrazuj”. Uczę tego krok po kroku w kursie o pisaniu prac z mądrym wsparciem AI, a najkrótszą próbkę tej metody wysyłam w trzech mailach z minikursu.
Najszybciej widać przy tym bibliografię. Nieistniejąca pozycja nie wymaga żadnego narzędzia ani procentu, wystarczy jedno zapytanie w katalogu, i o tym jest osobny tekst: dlaczego ChatGPT zmyśla źródła.
FAQ
Czy detektory AI kłamią?
Nie kłamią, bo nie orzekają o autorstwie. Podają prawdopodobieństwo oparte na przewidywalności tekstu, a ta sama miara daje różne wyniki w różnych narzędziach: w teście Decrypt jeden detektor dał tekstowi z 1776 roku 97,93 procent AI, a drugi 89 procent pewności, że pisał człowiek.
Czy detektor AI może pomylić tekst człowieka z tekstem AI?
Tak. Turnitin sam podaje około czterech procent fałszywych wskazań na poziomie zdania, a Uniwersytet Vanderbilta przeliczył deklarowany jeden procent na 750 prac rocznie przy własnej skali i wyłączył moduł detekcji.
Czy detektory AI działają na tekstach po polsku?
Nie ma publicznego pomiaru dla narzędzi komercyjnych. Jedyne dostępne dane pochodzą z benchmarku CEAID, gdzie najlepszy dostrojony detektor badawczy osiągnął dla polskiego AUC ROC 0,977, co nie przekłada się wprost na narzędzia używane na uczelniach.
Co zrobić, gdy detektor oznaczył mój tekst jako AI?
Nie obniżaj wyniku, bo to niczego nie dowodzi. Pokaż proces powstawania pracy: historię wersji, notatki, wcześniejsze szkice, i porozmawiaj o treści rozdziału. Rozpisałam tę rozmowę krok po kroku we wpisie o tym, czy JSA wykrywa ChatGPT.
Czy JSA podaje procent AI?
Nie. Moduł analizy SI oznacza w tekście podejrzane fragmenty na podstawie progu miary perplexity i nie wchodzi do wyników ogólnych raportu. Progi procentowe AI w JSA, które krążą po internecie, nie mają pokrycia w dokumentacji operatora systemu.
Czy warto sprawdzić własną pracę w darmowym detektorze?
Nie dla spokoju ducha. Wyniki różnią się między narzędziami o kilkadziesiąt punktów na tym samym akapicie, a jedyne, co z tego wynosisz, to lęk przed liczbą, której promotor i tak nie zobaczy.
Czy promotor może oprzeć decyzję na samym wyniku detektora?
Dokumentacja JSA mówi wprost, że system nie dokonuje wiążących ustaleń dotyczących wykroczeń, a wynik służy promotorowi do dalszej pracy ze studentem. W praktyce podstawą postępowania stają się zmyślone przypisy i źródła, których nie ma w bibliografii, nie sama liczba z narzędzia.
Jeśli masz dziś zrobić jedną rzecz po przeczytaniu tego tekstu, otwórz swoją bibliografię i sprawdź w Google Scholar trzy pierwsze pozycje. Taka weryfikacja zajmie pięć minut i powie Ci o Twoim ryzyku więcej niż każdy darmowy detektor.
Boisz się detektora tak, że odkładasz pisanie? Zrób quiz i sprawdź, co Cię blokuje.
Źródła wykorzystane w tym wpisie
- Edwards B., Why AI detectors think the US Constitution was written by AI, „Ars Technica”, lipiec 2023, za: AI Incident Database, report 3228 [dostęp: 25.09.2026].
- Jones K.M., ZeroGPT Flags 1836 Texas Declaration Of Independence As Nearly 90% AI-Generated, „The Dallas Express”, 27 maja 2025, dallasexpress.com [dostęp: 25.09.2026].
- Macko D., Kopal J., CEAID: Benchmark of Multilingual Machine-Generated Text Detection Methods for Central European Languages, preprint arXiv:2509.26051, wrzesień 2025 [dostęp: 25.09.2026].
- Nelson J., AI Detectors Claim the Declaration of Independence Was 98% AI-Generated, „Decrypt”, 14 października 2024, decrypt.co [dostęp: 25.09.2026].
- OpenAI, New AI classifier for indicating AI-written text, komunikat z 31 stycznia 2023 z aktualizacją z 20 lipca 2023, openai.com [dostęp: 25.09.2026].
- Ośrodek Przetwarzania Informacji PIB, Analiza użycia sztucznej inteligencji, baza wiedzy Jednolitego Systemu Antyplagiatowego, jsa-cp.opi.org.pl [dostęp: 25.09.2026].
- Pastis S., „Don’t use AI detectors for anything important”, says the author of the definitive „AI Weirdness” blog. Her own book failed the test, „Fortune”, 3 lipca 2023.
- Renfro Z., Hawthorne H., Hawkins J., Generative AI, Academic Integrity and the Question of Evidence, panel online, konferencja „AI and the Future of Education”, American Public University System, 16-17 października 2025, nagranie ok. 61 min, wypowiedzi [29:13], [33:17] i [45:58].
- Turnitin, Understanding the false positive rate for sentences of our AI writing detection capability, wpis na blogu z 14 czerwca 2023, turnitin.com [dostęp: 25.09.2026].
- Vanderbilt University, Guidance on AI Detection and Why We’re Disabling Turnitin’s AI Detector, Brightspace, 16 sierpnia 2023, vanderbilt.edu [dostęp: 25.09.2026].
- Webb M., AI Detection and assessment: an update for 2025, National Centre for AI, Jisc, 24 czerwca 2025, nationalcentreforai.jiscinvolve.org [dostęp: 25.09.2026].
Cytaty z komentarzy studenckich pochodzą z publicznych dyskusji pod filmami o antyplagiacie oraz z korespondencji z czytelnikami. Podaję je bez nazw użytkowników i bez zmian w treści.